PrismML dévoile Bonsai, le plus grand modèle d'IA optimisé pour les smartphones
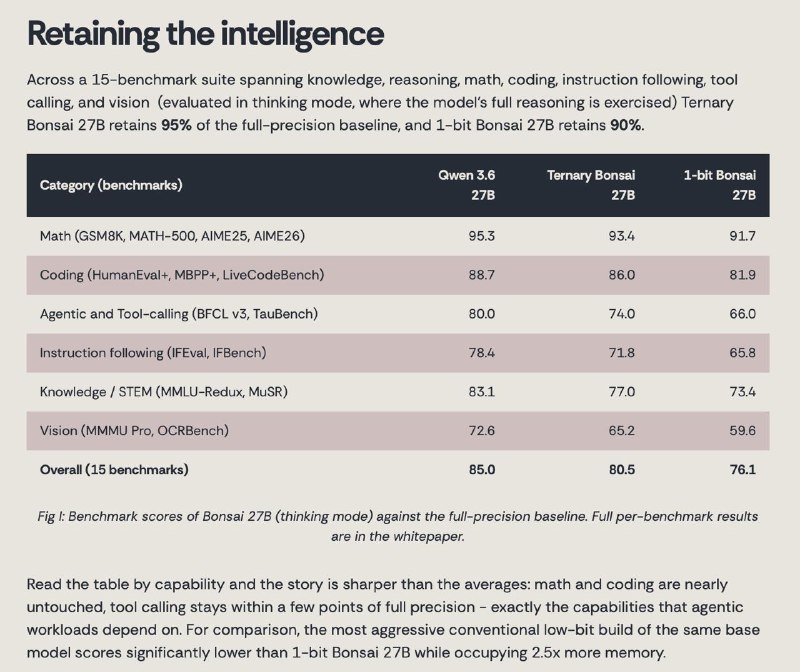
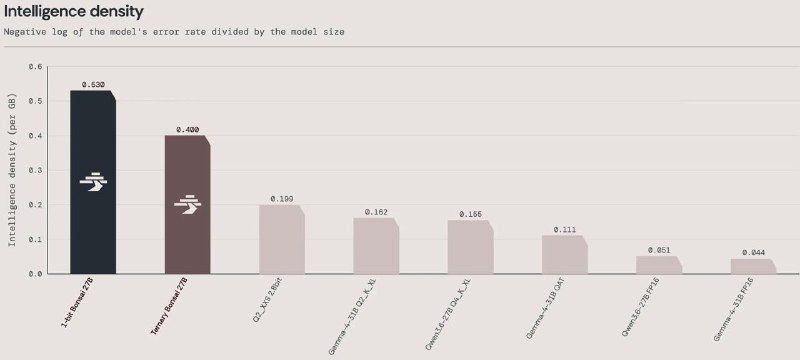
La startup PrismML a présenté Bonsai, un modèle de 27 milliards de paramètres conçu spécifiquement pour l'exécution locale sur mobile. Grâce à une technique avancée d'entraînement quantifié, il maintient une qualité exceptionnelle tout en réduisant drastiquement son empreinte mémoire.
PrismML dévoile Bonsai, le plus grand modèle d'IA optimisé pour les smartphones
Le nouveau modèle Bonsai se distingue par ses 27 milliards de paramètres. En temps normal, un tel modèle est impossible à exécuter sur un téléphone : en précision native 16 bits, il occuperait environ 54 Go, et même compressé en 4 bits, il nécessiterait toujours près de 18 Go. Il ne peut simplement pas tenir dans la mémoire d'un smartphone.
Cependant, malgré sa taille imposante, Bonsai est spécifiquement optimisé pour le déploiement local. Le modèle repose sur l'architecture Qwen3.6-27B, mais les développeurs n'ont pas utilisé la quantification classique ; ils ont employé une technique appelée « Quantization-Aware Training » (entraînement conscient de la quantification).
Concrètement, cela signifie que les poids n'ont pas été tronqués après coup, mais qu'ils ont été progressivement entraînés à s'adapter aux valeurs discrètes. Techniquement, lors du passage avant (forward pass), les poids sont arrondis à des valeurs discrètes, et le modèle effectue ses prédictions avec ces valeurs, comme dans la version finale compressée. Toutefois, lors du rétropropagation (backward pass), les gradients sont calculés comme si aucun arrondi n'avait eu lieu, permettant au modèle de recevoir des signaux significatifs pour mettre à jour ses poids, malgré leur nature discrète. En d'autres termes, le modèle apprend efficacement comment dimensionner ses poids de manière optimale dès la phase d'entraînement.
Grâce à cette ingénierie, le modèle conserve entre 89 % et 95 % de la qualité de la version pleine taille, tout en occupant 9 à 14 fois moins de mémoire. Par rapport à la quantification conventionnelle, qui sacrifie souvent une part importante de la performance, ces chiffres sont tout simplement phénoménaux.
Deux options sont disponibles : une version ternaire (poids de -1, 0 ou +1 ; occupe ~5,9 Go) et une version classique 1 bit (3,9 Go). Cette dernière s'intègre facilement dans un iPhone 17 Pro. Les deux variantes sont multimodales, avec une fenêtre de contexte de 262 000 tokens. Le modèle est open-source sous licence Apache 2.0.
Pourquoi c'est important
AnalyseCe modèle ouvre de nouvelles perspectives pour le déploiement de l'intelligence artificielle sur les appareils mobiles, transformant potentiellement l'interaction utilisateur-technologie. Il démontre comment des approches innovantes de quantification peuvent préserver une haute qualité tout en réduisant considérablement les exigences matérielles.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs