ReflectionAI stellt Beam vor: Open-Source-Modell als Alternative zu chinesischen LLMs
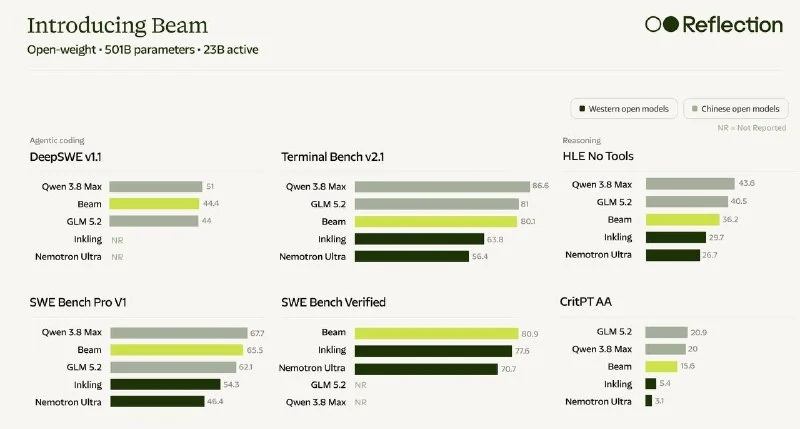
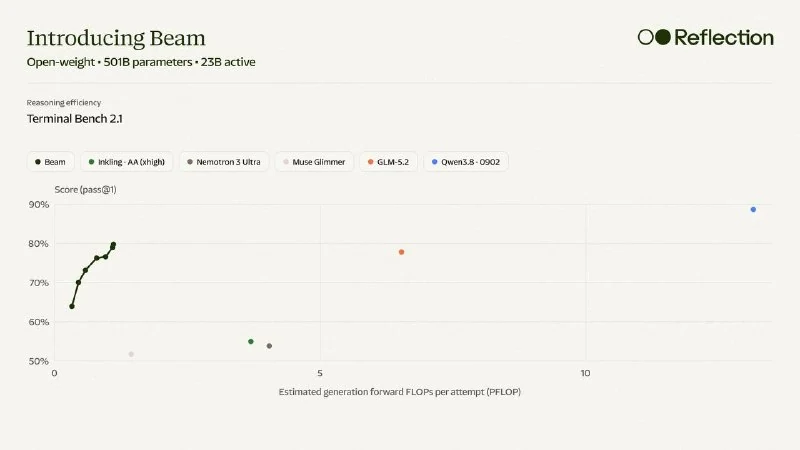
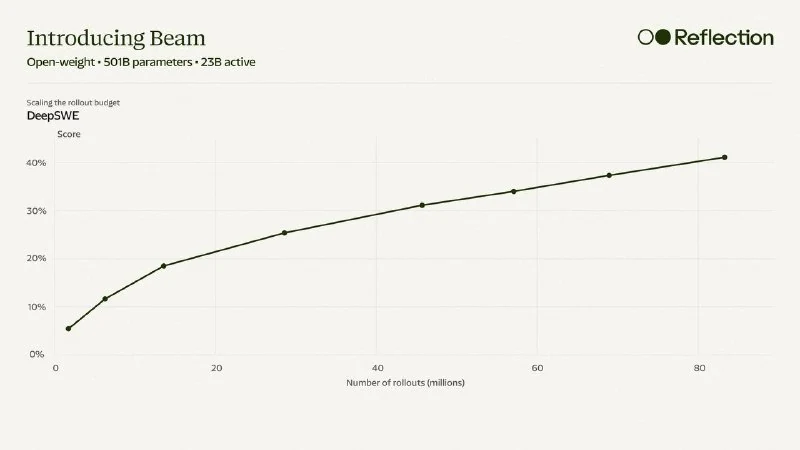
Das von Nvidia unterstützte Startup ReflectionAI hat Beam veröffentlicht, ein Open-Source-Modell mit 501 Milliarden Parametern, das GLM-5.2 in der Leistung ebenbürtig sein soll und dabei eine 3–4-fach höhere Effizienz bei der Inferenz bietet.
ReflectionAI, ein durch Nvidia finanziertes Startup, hat Beam vorgestellt – ein leistungsstarkes Open-Source-KI-Modell, das als direkte Alternative zu chinesischen Open-Weight-Large-Language-Models (LLMs) positioniert wird.
Nach den vorliegenden Metriken scheint Beam leistungsmäßig auf Augenhöhe mit GLM-5.2 zu liegen. Das Team behauptet, dass das Modell während der Inferenzphase um das Drei- bis Vierfache effizienter arbeitet, was zu einer geringeren Token-Nutzung sowie schnelleren und kostengünstigeren Task-Abschlüssen führt.
Technische Details:
- Architektur: 501 Milliarden Parameter insgesamt, davon sind 23 Milliarden aktiv.
- Training: Das Modell wurde von Grund auf neu trainiert; die Vor-Trainingsphase dauerte einen Monat und basierte auf 24 Billionen Tokens.
- Reinforcement Learning: ReflectionAI führte die bislang größte dokumentierte Reinforcement-Learning-(RL)-Durchführung durch. Diese lief vier Wochen lang auf 10.500 GB300-Chips. Berichten zufolge mietet das Unternehmen diese Chips für 150 Millionen US-Dollar pro Monat.
Die Gewichte des Modells sollen „bald“ unter der Apache 2.0 Lizenz verfügbar gemacht werden.
Ein vollständiger Ersatz für chinesische Open-Source-Modelle ist zwar noch nicht erreicht, doch angesichts dessen, dass dies das erste Modell des Startups ist, sind die bisherigen Ergebnisse bereits bemerkenswert.
Warum das wichtig ist
AnalyseBeam demonstriert, dass westliche Startups große Open-Weight-Modelle entwickeln können, die mit dem chinesischen Ökosystem konkurrieren und gleichzeitig die Inferenzkosten senken. Die Verfügbarkeit der Apache-2.0-Gewichte würde Entwicklern eine weitere Option für lokale und Cloud-Bereitstellungen eröffnen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern