MiniMax stellt Modell M3.1 Flash vor
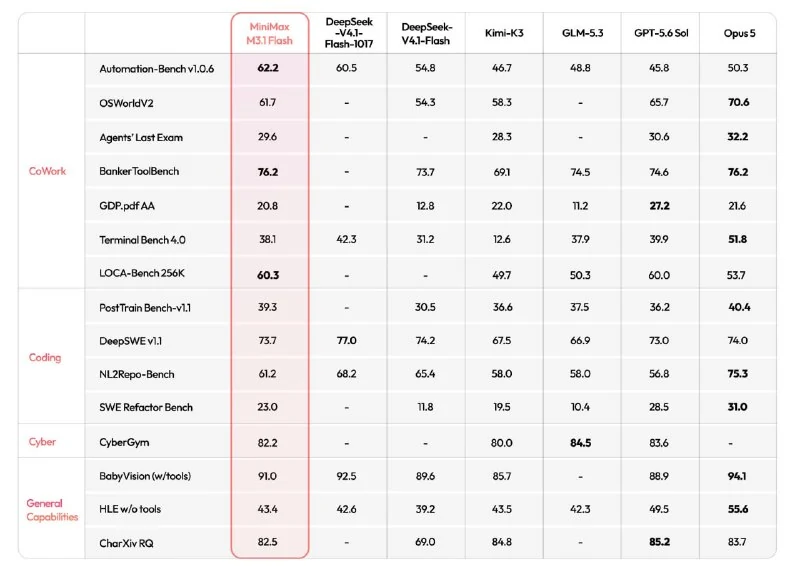
MiniMax hat M3.1 Flash offiziell veröffentlicht: Das Modell erzeugt über 200 Tokens pro Sekunde, übertrifft mehrere chinesische Modelle bei KI-Agenten-Benchmarks und ist deutlich günstiger als M3.
MiniMax M3.1 Flash offiziell verfügbar
Space Bunny war eine frühe Version dieses Modells; nun hat das Team es als M3.1 Flash vorgestellt. Die Spezifikationen wirken vielversprechend.
- Über 200 Tokens pro Sekunde.
- Besser als andere chinesische Modelle in Benchmarks für KI-Agenten.
- API-Preis: etwa 0,15 USD pro Million Eingabe-Tokens und 0,60 USD pro Million Ausgabe-Tokens.
- Modellgewichte werden am 23. Oktober veröffentlicht.
- Eine Pro-Version ist in Vorbereitung.
Das ist ein großer Schritt gegenüber M3: Das neue Modell ist fast dreimal schneller und 70 % günstiger.
Das Modell ist bereits verfügbar über die API und die Preistarifpläne von MiniMax. Bis zum 25. Oktober kann es im Rahmen dieser Tarife kostenlos genutzt werden.
In OpenCode kann es in den nächsten drei Tagen kostenlos getestet werden.
Warum das wichtig ist
AnalyseM3.1 Flash kombiniert hohe Durchsatzleistung, niedrigere Kosten und angekündigte offene Gewichte — relevant für Entwickler von KI-Agenten und LLM-Anwendungen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern