MiniMax lança o modelo M3.1 Flash
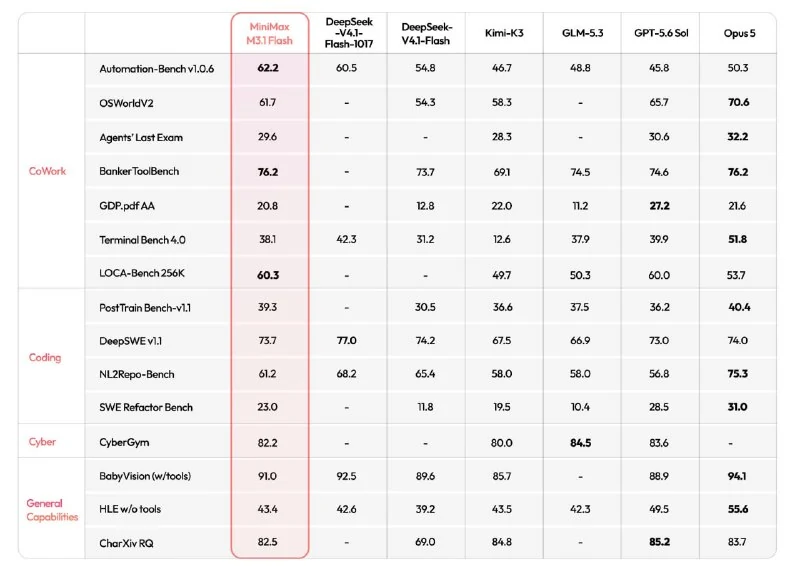
A MiniMax lançou oficialmente o M3.1 Flash, modelo que gera mais de 200 tokens por segundo, supera vários modelos chineses em benchmarks de agentes de IA e é muito mais barato que o M3.
MiniMax M3.1 Flash já está oficialmente disponível
Space Bunny era uma versão inicial deste modelo, e agora a equipe o apresentou como M3.1 Flash. As especificações parecem promissoras.
- Mais de 200 tokens por segundo.
- Supera outros modelos chineses em benchmarks para agentes de IA.
- O preço da API é de aproximadamente US$ 0,15 por milhão de tokens de entrada e US$ 0,60 por milhão de tokens de saída.
- Os pesos do modelo serão publicados em 23 de outubro.
- Uma versão Pro também está sendo preparada.
Isso representa um grande avanço em relação ao M3: o novo modelo é quase três vezes mais rápido e 70% mais barato.
O modelo já está disponível por meio da API e dos planos de preços da MiniMax. Até 25 de outubro, pode ser usado gratuitamente dentro desses planos.
Ele também pode ser testado gratuitamente no OpenCode nos próximos três dias.
Por que isso importa
AnáliseO M3.1 Flash combina alto throughput, custo menor e futura publicação de pesos, sendo relevante para desenvolvedores de agentes de IA e aplicações LLM.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores