Claude тепер сам оцінює потенційно шкідливі запити
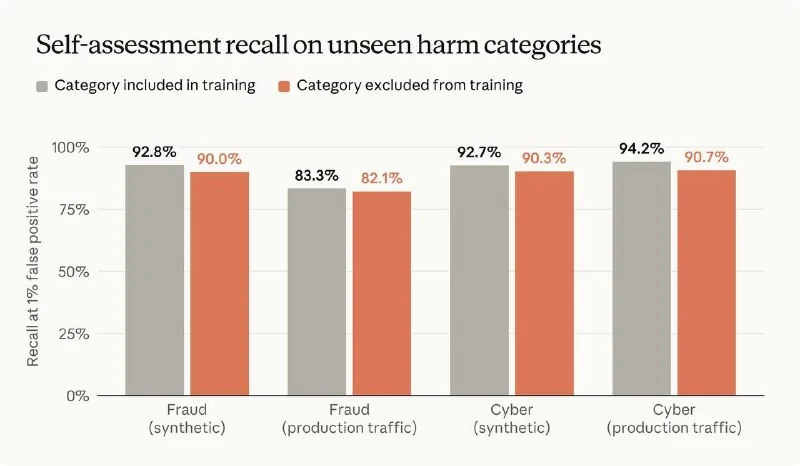
Anthropic запровадила механізм, за яким Claude після відповіді отримує приховану інструкцію для короткої оцінки, чи містив діалог потенційно шкідливий запит.
Одразу після відповіді модель отримує приховану інструкцію й коротко оцінює, чи містив розмова потенційно шкідливий запит.
Метод уже працює в усіх моделях, починаючи з Fable 5, на більшості трафіку, окрім клієнтів із нульовим зберіганням даних. Сам по собі він нічого не блокує, а лише позначає діалоги.
Чому це важливо
АналітикаЦе важливо, бо показує, як розробники ШІ вбудовують внутрішню самооцінку безпеки без блокування запитів, створюючи легкий шар спостережності та впливаючи на конфіденційність діалогів.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Claude почав перевіряти відповіді на шкоду без повторного звернення до політик безпеки
Anthropic навчила Claude відтворювати рішення класифікатора безпеки, щоб виявляти потенційну шкоду в відповідях без дорогих повторних звернень до політик компанії.
На китайських форумах описали нібито бальну систему блокування акаунтів Claude
Користувачі стверджують, що Anthropic нібито нараховує стартові бали новим акаунтам Claude та знімає їх за зміну IP, пристроїв, проксі, ранню підписку Max або використання лише веб-версії.
Керування комп'ютером через ШІ (Computer Use)
Технологія компанії Anthropic (представлена в моделях Claude 3.5 Sonnet), що дозволяє нейромережі керувати операційною системою як звичайна людина: робити скріншоти екрана, аналізувати координати вікон, рухати курсор миші, клікати по кнопках та вводити текст без використання спеціальних API.
Конституційний ШІ (Constitutional AI / RLAIF)
Метод вирівнювання поведінки моделей, розроблений лабораторією Anthropic (творцями Claude). Замість використання мільйонів годин ручної праці людей, модель сама критикує та виправляє власні відповіді, спираючись на чіткий звід етичних принципів («Конституцію»).