Claude ahora autoevalúa solicitudes potencialmente dañinas
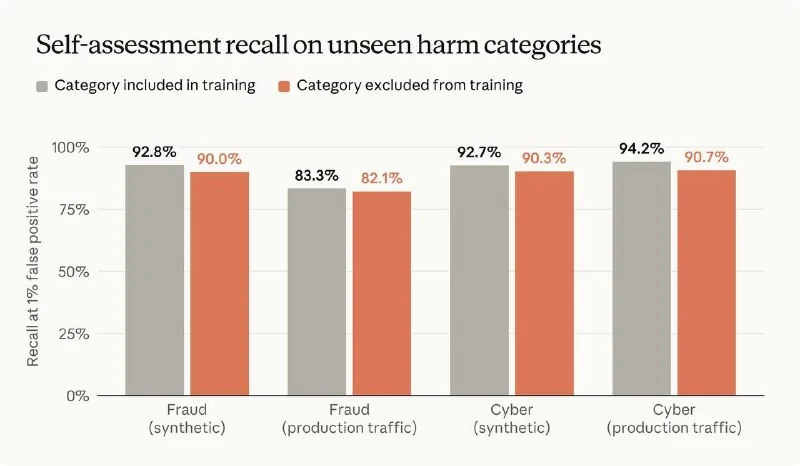
Anthropic indica que Claude recibe una instrucción oculta después de cada respuesta para evaluar brevemente si la conversación incluyó una solicitud potencialmente dañina.
Inmediatamente después de responder, el modelo recibe una instrucción oculta y evalúa brevemente si la conversación contenía una solicitud potencialmente dañina.
El método ya está activo en todos los modelos a partir de Fable 5 para la mayor parte del tráfico, excepto en los clientes con almacenamiento cero de datos. Por sí solo, no bloquea nada; solo marca los diálogos.
Por qué es importante
AnálisisMuestra cómo los proveedores de IA están incorporando revisiones internas de seguridad en las respuestas del modelo, creando una capa de supervisión ligera sin bloqueo inmediato.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Anthropic entrena a Claude para imitar un clasificador de seguridad sin consultar las políticas
Claude ahora evalúa en silencio si sus respuestas pueden haber causado daño, mientras Anthropic destila un clasificador costoso en un mecanismo más barato.
Usuarios de foros chinos afirman haber descifrado el sistema de puntos que bloquea cuentas de Claude
Los usuarios aseguran que Anthropic asigna puntos iniciales a las nuevas cuentas de Claude y los reduce por cambiar IP, dispositivos o proxies, suscribirse a Max demasiado pronto o usar solo la versión web.
Control de Computadora a Través de IA (Computer Use)
La tecnología de Anthropic (presentada en los modelos Claude 3.5 Sonnet) permite a la red neuronal controlar el sistema operativo como lo haría una persona: tomar capturas de pantalla, analizar coordenadas de ventanas, mover el cursor, hacer clic en botones e ingresar texto sin utilizar APIs especiales.
Inteligencia Artificial Constitucional (Constitutional AI / RLAIF)
Método de alineación del comportamiento de modelos desarrollado por el laboratorio Anthropic (creadores de Claude). En lugar de utilizar millones de horas de trabajo manual, el modelo critica y corrige sus propias respuestas basándose en un conjunto claro de principios éticos ('Constitución').