Claude évalue désormais lui-même les requêtes potentiellement nuisibles
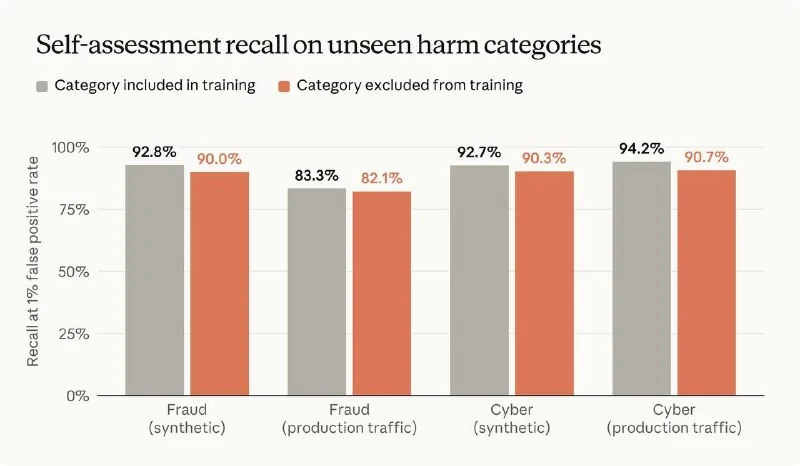
Selon Anthropic, Claude reçoit après chaque réponse une instruction cachée pour évaluer brièvement si la conversation contenait une requête potentiellement nuisible.
Immédiatement après la réponse, le modèle reçoit une instruction cachée et évalue brièvement si la conversation contenait une requête potentiellement nuisible.
La méthode est déjà active dans tous les modèles à partir de Fable 5 pour une grande partie du trafic, sauf pour les clients avec conservation nulle des données. En elle-même, elle ne bloque rien ; elle ne fait que signaler les dialogues.
Pourquoi c'est important
AnalyseCela montre comment les fournisseurs d’IA intègrent une revue de sécurité interne directement dans les réponses du modèle, créant une couche de surveillance légère sans blocage immédiat.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Anthropic entraîne Claude à reproduire un classificateur de sécurité sans consulter les politiques
Claude vérifie désormais discrètement si ses réponses ont pu contribuer à un préjudice, tandis qu’Anthropic réduit le coût d’un classificateur de sécurité très gourmand en calcul.
Des utilisateurs de forums chinois affirment avoir compris le système de points utilisé pour bloquer les comptes Claude
Ils affirment qu’Anthropic attribue des points initiaux aux nouveaux comptes Claude et en retire pour des changements d’IP, d’appareils ou de proxys, un abonnement Max trop précoce ou l’utilisation seule de la version web.
Contrôle de l'ordinateur par IA (Computer Use)
Technologie développée par Anthropic (introduite dans les modèles Claude 3.5 Sonnet) qui permet à un réseau neuronal de contrôler le système d'exploitation comme un humain : prendre des captures d'écran, analyser les coordonnées des fenêtres, déplacer le curseur de la souris, cliquer sur des boutons et saisir du texte sans utiliser d'API spécifiques.
Constitutional AI (RLAIF)
Une méthode d'alignement des modèles développée par le laboratoire Anthropic (créateurs de Claude). Au lieu de recourir à des millions d'heures de travail humain, le modèle critique et corrige ses propres réponses en s'appuyant sur un ensemble clair de principes éthiques (« la Constitution »).