Claude bewertet jetzt potenziell schädliche Anfragen selbst
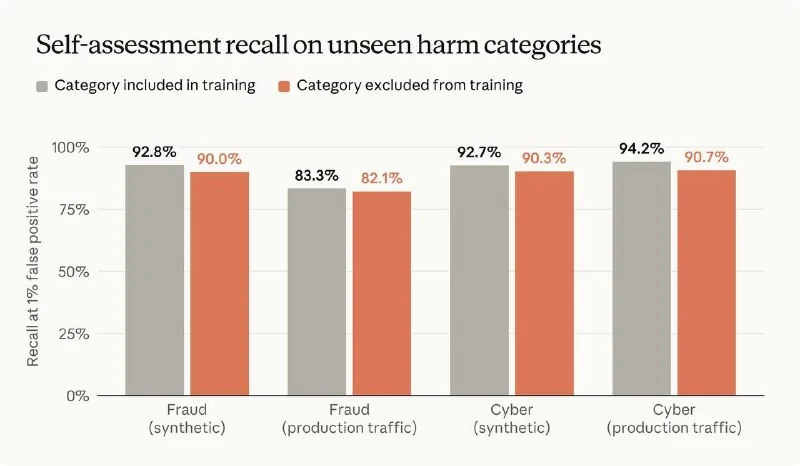
Anthropic zufolge erhält Claude nach jeder Antwort eine versteckte Anweisung, um kurz zu bewerten, ob das Gespräch eine potenziell schädliche Anfrage enthielt.
Unmittelbar nach der Antwort erhält das Modell eine versteckte Anweisung und bewertet kurz, ob das Gespräch eine potenziell schädliche Anfrage enthielt.
Die Methode ist bereits in allen Modellen ab Fable 5 für den Großteil des Traffics aktiv, außer bei Kunden mit Null-Datenspeicherung. Für sich genommen blockiert sie nichts, sondern markiert nur Dialoge.
Warum das wichtig ist
AnalyseEs zeigt, wie KI-Anbieter interne Sicherheitsprüfungen direkt in Modellantworten einbetten, um eine leichte Überwachungsebene ohne sofortige Blockierung zu schaffen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Anthropic trainiert Claude, einen Sicherheitsklassifikator ohne erneute Policy-Prüfung nachzubilden
Claude prüft nun unbemerkt, ob seine Antworten Schaden verursacht haben könnten, während Anthropic einen rechenintensiven Klassifikator in einen günstigeren Mechanismus überführt.
Nutzer chinesischer Foren behaupten, das Punktesystem für Claude-Kontosperrungen entschlüsselt zu haben
Nutzer behaupten, Anthropic vergebe Startpunkte für neue Claude-Konten und ziehe Punkte ab, wenn IP, Geräte oder Proxys wechseln, ein Max-Abo zu früh abgeschlossen oder nur die Web-Version genutzt wird.
Steuerung des Computers durch KI (Computer Use)
Eine Technologie von Anthropic (vorgestellt in den Modellen Claude 3.5 Sonnet), die es neuronalen Netzen ermöglicht, das Betriebssystem wie ein Mensch zu steuern: Bildschirm-Screenshots erstellen, Fensterkoordinaten analysieren, den Mauszeiger bewegen, auf Schaltflächen klicken und Text eingeben – ohne Verwendung spezieller APIs.
Constitutional AI (RLAIF)
Ein von Anthropic (den Entwicklern von Claude) konzipiertes Verfahren zur Ausrichtung des Modellverhaltens. Anstatt Millionen von Stunden menschlicher Arbeit zu nutzen, kritisiert und korrigiert das Modell seine eigenen Antworten auf der Grundlage eines klar definierten Kodex ethischer Grundsätze (der „Verfassung“).