Claude agora autoavalia solicitações potencialmente prejudiciais
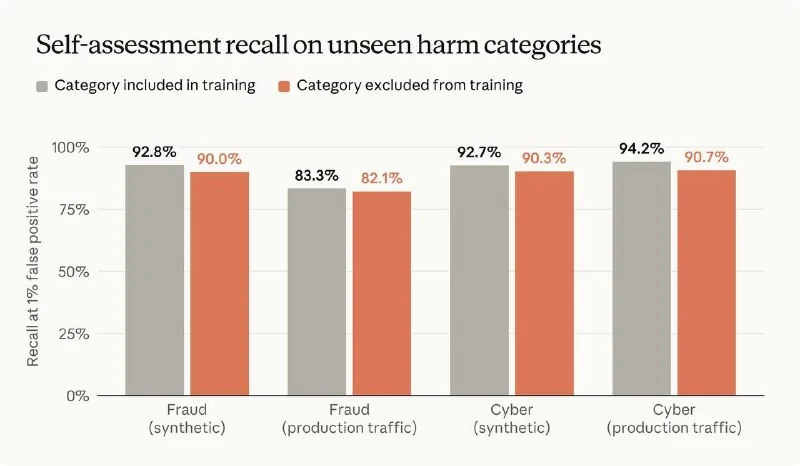
Segundo a Anthropic, o Claude recebe uma instrução oculta após cada resposta para avaliar brevemente se a conversa incluiu uma solicitação potencialmente prejudicial.
Imediatamente após responder, o modelo recebe uma instrução oculta e avalia brevemente se a conversa continha uma solicitação potencialmente prejudicial.
O método já está ativo em todos os modelos a partir do Fable 5 para a maior parte do tráfego, exceto em clientes com armazenamento zero de dados. Por si só, ele não bloqueia nada; apenas marca os diálogos.
Por que isso importa
AnáliseIsso mostra como provedores de IA estão incorporando revisões internas de segurança diretamente nas respostas do modelo, criando uma camada de monitoramento leve sem bloqueio imediato.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Anthropic treina Claude para reproduzir classificador de segurança sem consultar políticas
Claude agora faz uma verificação interna discreta para avaliar se suas respostas podem ter causado dano, enquanto a Anthropic reduz o custo de um classificador pesado.
Usuários de fóruns chineses afirmam ter decifrado o sistema de pontos que bloqueia contas do Claude
Eles alegam que a Anthropic atribui pontos iniciais a novas contas do Claude e os reduz por mudanças de IP, dispositivos ou proxies, assinatura Max muito cedo ou uso apenas da versão web.
Controle do Computador por IA (Computer Use)
Tecnologia da Anthropic (apresentada nos modelos Claude 3.5 Sonnet) que permite à rede neural controlar o sistema operacional como um ser humano: tirar capturas de tela, analisar coordenadas de janelas, mover o cursor do mouse, clicar em botões e inserir texto sem o uso de APIs específicas.
Constitutional AI (RLAIF)
An alignment method developed by Anthropic (the creators of Claude). Instead of relying on millions of hours of human labor, the model critiques and revises its own responses based on a clear set of ethical principles (the \"Constitution\").