Claude teraz sam ocenia potencjalnie szkodliwe zapytania
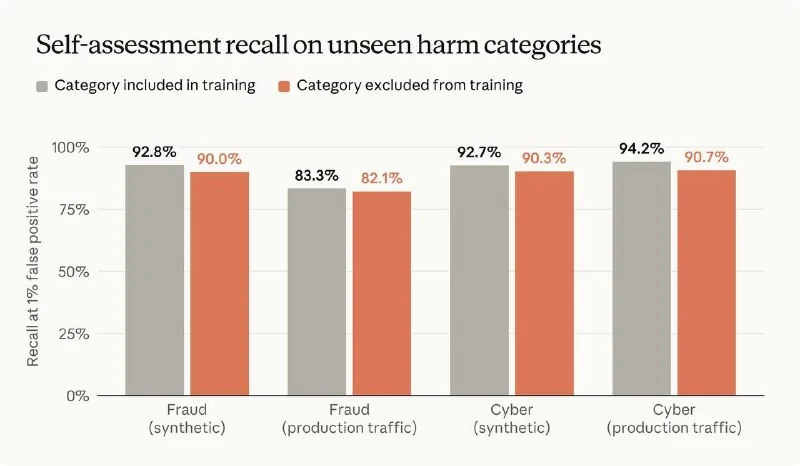
Według Anthropic Claude otrzymuje ukrytą instrukcję po każdej odpowiedzi, aby krótko ocenić, czy rozmowa zawierała potencjalnie szkodliwe zapytanie.
Tuż po odpowiedzi model otrzymuje ukrytą instrukcję i krótko ocenia, czy rozmowa zawierała potencjalnie szkodliwe zapytanie.
Metoda działa już we wszystkich modelach począwszy od Fable 5 dla większości ruchu, z wyjątkiem klientów z zerowym przechowywaniem danych. Sama w sobie nic nie blokuje; jedynie oznacza dialogi.
Dlaczego to ważne
AnalizaPokazuje to, jak dostawcy AI wbudowują wewnętrzną ocenę bezpieczeństwa bezpośrednio w odpowiedzi modelu, tworząc lekką warstwę monitorowania bez natychmiastowego blokowania.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Anthropic trenuje Claude’a do odtwarzania klasyfikatora bezpieczeństwa bez konsultacji z politykami
Claude teraz dyskretnie sprawdza, czy jego odpowiedzi mogły przyczynić się do szkody, a Anthropic zamienia kosztowny klasyfikator w tańszy mechanizm.
Użytkownicy chińskich forów twierdzą, że rozszyfrowali system punktowy blokujący konta Claude
Użytkownicy twierdzą, że Anthropic przyznaje nowe punkty startowe kontom Claude i odejmuje je za zmiany IP, urządzeń lub proxy, zbyt wczesną subskrypcję Max albo korzystanie tylko z wersji webowej.
Sterowanie komputerem przez AI (Computer Use)
Technologia firmy Anthropic (wprowadzona w modelach Claude 3.5 Sonnet), która pozwala sieci neuronowej sterować systemem operacyjnym jak zwykły użytkownik: robić zrzuty ekranu, analizować współrzędne okien, poruszać kursorem myszy, klikać przyciski i wprowadzać tekst bez użycia dedykowanych API.
Konstytucyjna AI (Constitutional AI / RLAIF)
Metoda wyrównywania zachowań modeli, opracowana przez laboratorium Anthropic (twórców Claude). Zamiast wykorzystywać miliony godzin pracy ludzkiej, model sam krytykuje i poprawia własne odpowiedzi, opierając się na jasnym zbiorze zasad etycznych („Konstytucji”).