Claude теперь сам оценивает потенциально вредные запросы
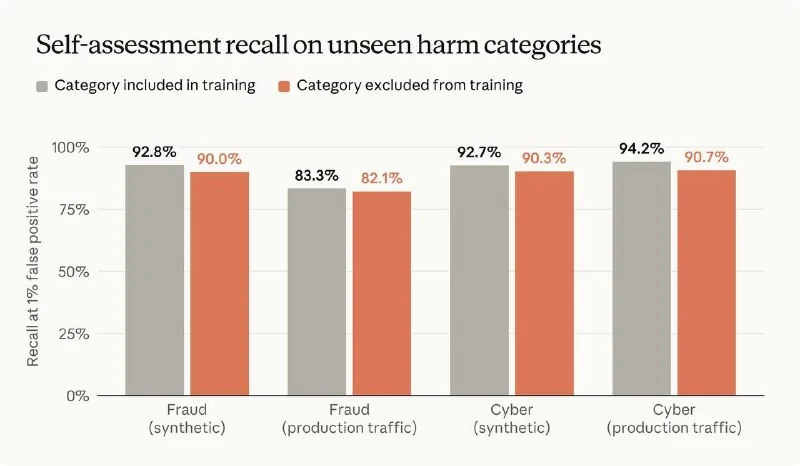
Anthropic сообщает, что Claude получает скрытую инструкцию после ответа и кратко оценивает, был ли в разговоре потенциально вредный запрос.
Сразу после ответа модель получает скрытую инструкцию и коротко оценивает, был ли в разговоре потенциально вредный запрос.
Метод уже работает во всех моделях начиная с Fable 5 на большей части трафика, кроме клиентов с нулевым хранением данных. Сам по себе он ничего не блокирует, а только помечает диалоги.
Почему это важно
АналитикаЭто важно, потому что показывает, как AI-лаборатории встраивают внутреннюю оценку безопасности без блокировки запросов, создавая слой мониторинга и затрагивая вопросы конфиденциальности диалогов.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Anthropic обучила Claude имитировать классификатор безопасности без повторных обращений к политикам
Claude теперь незаметно проверяет, не способствовал ли его ответ причинению вреда, а результаты передаются специалистам Anthropic для дальнейшего рассмотрения.
На китайских форумах считают, что разобрались, как работает блокировка аккаунтов Claude
Пользователи утверждают, что у Anthropic есть балльная система: аккаунту начисляют стартовые баллы, а за «подозрительные» действия снимают их; при падении ниже порога следует бан.
Управление компьютером через ИИ (Computer Use)
Технология компании Anthropic (представленная в моделях Claude 3.5 Sonnet), позволяющая нейросети управлять операционной системой как обычный человек: делать скриншоты экрана, анализировать координаты окон, перемещать курсор мыши, кликать по кнопкам и вводить текст без использования специальных API.
Конституционный ИИ (Constitutional AI / RLAIF)
Метод выравнивания поведения моделей, разработанный лабораторией Anthropic (создателями Claude). Вместо использования миллионов часов ручного труда людей, модель сама критикует и исправляет свои ответы, опираясь на четкий свод этических принципов («Конституцию»).