FreeToken: Rewolucja w uruchamianiu dużych modeli MoE na standardowych komputerach
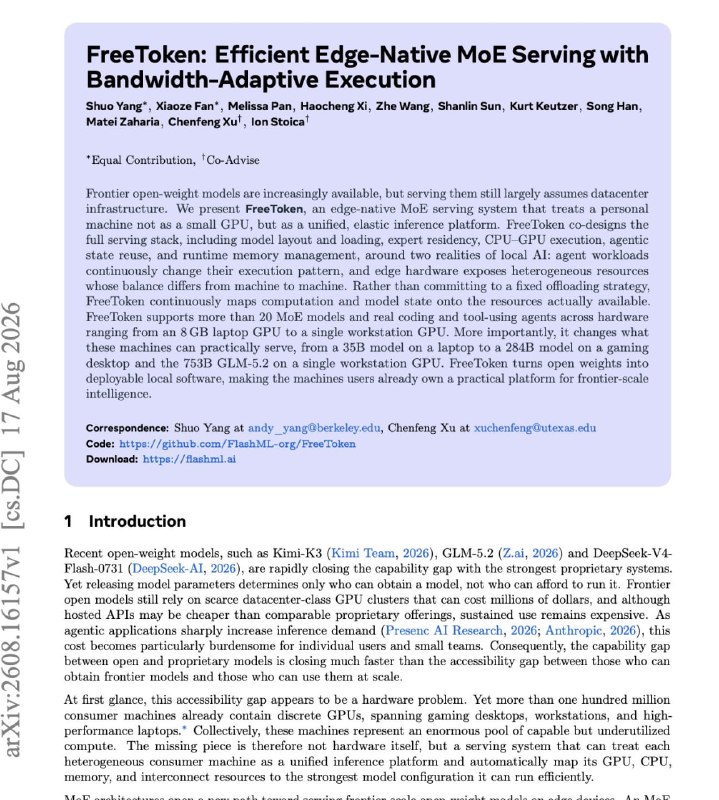
FreeToken to nowy system umożliwiający efektywne uruchamianie ultra-dużych modeli Mixture-of-Experts (MoE) na zwykłych PC, osiągając imponujące prędkości generowania bez konieczności ekstremalnej kwantyzacji.
Wow, teraz nawet komputer gamingowy może uruchamiać zaawansowane modele z interaktywną prędkością, korzystając z oficjalnych wag i bez stosowania ekstremalnej kwantyzacji.
Badacze z UC Berkeley, MIT oraz UT Austin udostępnili kod źródłowy FreeToken – systemu zaprojektowanego specjalnie do uruchamiania ultra-dużych modeli MoE na standardowych komputerach.
W publikacji naukowcy przedstawili bardzo imponujące wyniki:
- Qwen3.6 35B → laptop z RTX 4060 8GB → 39 tokenów/s
- DeepSeek-V4-Flash 284B → RTX 5090 → 22–25 tokenów/s
- GLM-5.2 753B → RTX PRO 6000 → 15 tokenów/s
W porównaniu z Ollama, prędkość generowania jest 3–4 razy wyższa, a przetwarzanie kontekstu wejściowego jest od 6 do 30 razy szybsze.
Oznacza to, że laptop gamingowy wyposażony jedynie w 8 GB pamięci wideo jest już w stanie uruchomić model z 35 miliardami parametrów z prędkością niemal 40 tokenów na sekundę.
Co więcej, jest to szybciej niż medianowa prędkość generowania Codex wynosząca 33 tokeny/s, o czym wspominają autorzy w pracy.
Głównym założeniem FreeToken jest synergiczna współpraca GPU, CPU, RAM-u oraz magistrali PCIe.
Ponieważ modele MoE aktywują tylko niewielką część ekspertów dla każdego tokenu, nie ma potrzeby przechowywania setek miliardów parametrów w pamięci wideo przez cały czas.
FreeToken dynamicznie decyduje, które części modelu utrzymywać w VRAM, które tymczasowo przenosić z RAM-u do GPU, a które obliczać na procesorze centralnym.
Na etapie przetwarzania kontekstu wejściowego system pre-loaduje ekspertów następnej warstwy. Podczas generowania dynamicznie rozdziela obliczenia w zależności od aktualnej wydajności CPU, GPU i PCIe.
Istnieje również osobny Agent State Cache.
Gdy agent wywołuje narzędzia, zmienia kontekst lub kontynuuje stare zadanie, FreeToken może pominąć znaczną część ponownego przetwarzania kontekstu.
FreeToken posiada pełny graficzny interfejs użytkownika.
Nie ma potrzeby konwertowania modeli do formatu GGUF ani kompilowania projektu z kodu źródłowego.
Ponadto FreeToken Desktop ma wbudowane integracje z agentami – wystarczy wybrać model, aplikację i uruchomić go.
Dlaczego to ważne
AnalizaTen system demokratyzuje dostęp do zaawansowanych technologii AI, umożliwiając uruchamianie dużych modeli na standardowym sprzęcie. Może to fundamentalnie zmienić podejście do pracy z sztuczną inteligencją i znacząco obniżyć bariery wejścia dla deweloperów.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami