FreeToken: Neue Software ermöglicht den Betrieb großer MoE-Modelle auf Standard-PCs
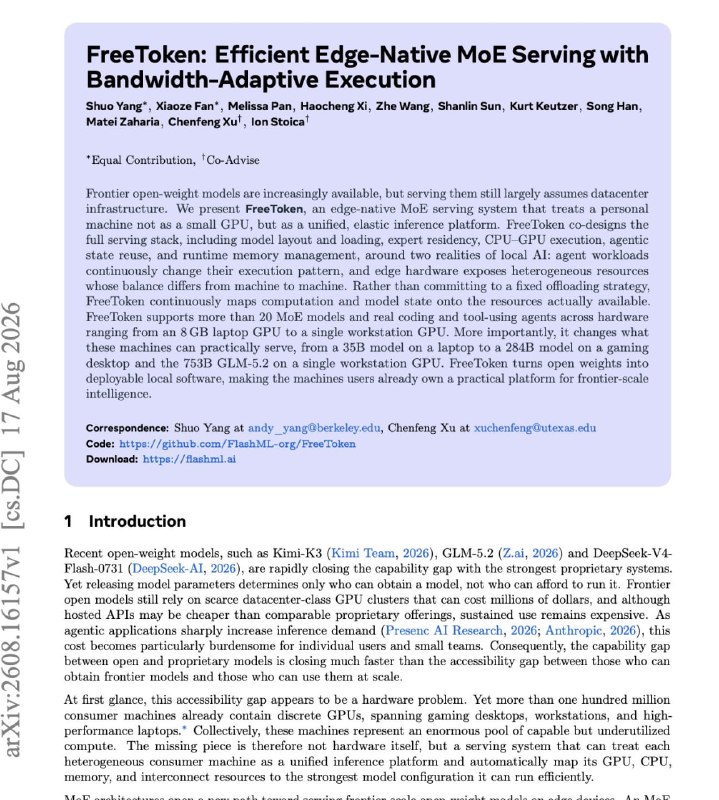
Forscher von UC Berkeley, MIT und UT Austin haben FreeToken vorgestellt, ein System, das die Ausführung ultra-großer Mixture-of-Experts-Modelle (MoE) auf herkömmlicher Hardware revolutioniert. Die Open-Source-Lösung erreicht dabei beeindruckende Geschwindigkeiten, die weit über denen gängiger Alternativen wie Ollama liegen.
Wow – jetzt können sogar Gaming-PCs fortgeschrittene Modelle mit interaktiven Geschwindigkeiten ausführen, indem sie offizielle Gewichte verwenden, ohne auf extreme Quantisierung zurückgreifen zu müssen.
Forscher der University of California, Berkeley, des Massachusetts Institute of Technology (MIT) und der University of Texas at Austin haben den Quellcode von FreeToken veröffentlicht. Es handelt sich um ein speziell entwickeltes System, das darauf ausgelegt ist, ultra-große MoE-Modelle auf regulären Computern zum Laufen zu bringen.
In ihrem Fachartikel präsentieren die Autoren sehr überzeugende Ergebnisse:
- Qwen3.6 35B → Laptop mit RTX 4060 (8GB VRAM) → 39 Tokens/s
- DeepSeek-V4-Flash 284B → RTX 5090 → 22–25 Tokens/s
- GLM-5.2 753B → RTX PRO 6000 → 15 Tokens/s
Im Vergleich zu Ollama ist die Generierungsgeschwindigkeit bei FreeToken drei- bis viermal höher, während die Verarbeitung des Eingabekontexts sechs- bis dreißigmal schneller erfolgt.
Das bedeutet konkret: Ein Gaming-Laptop mit lediglich 8 GB Video-RAM kann bereits ein Modell mit 35 Milliarden Parametern mit einer Rate von fast 40 Tokens pro Sekunde betreiben. Dies ist sogar schneller als die mediane Generierungsgeschwindigkeit von Codex, die in dem Papier mit 33 Tokens/s angegeben wird.
Wie funktioniert FreeToken?
Die Kernidee von FreeToken besteht darin, GPU, CPU, RAM und PCIe-Bus koordiniert zusammenarbeiten zu lassen.
Da MoE-Modelle für jedes Token nur einen kleinen Teil der Experten aktivieren, ist es nicht notwendig, Hunderte von Milliarden Parametern dauerhaft im Video-RAM vorzuhalten. FreeToken entscheidet dynamisch, welche Teile des Modells im VRAM verbleiben, welche temporär vom RAM zur GPU verschoben werden und welche Berechnungen auf der CPU erfolgen.
Während der Phase der Eingabekontext-Verarbeitung lädt das System die Experten der nächsten Schicht vorab. Bei der Generierung verteilt es die Berechnungen dynamisch basierend auf der aktuellen Leistungsfähigkeit von CPU, GPU und PCIe.
Ein weiteres Highlight ist der separate Agent State Cache. Wenn ein Agent Tools aufruft, den Kontext ändert oder eine alte Aufgabe fortsetzt, kann FreeToken einen Großteil der erneuten Kontextverarbeitung überspringen.
Benutzerfreundlichkeit und Integration
FreeToken wird mit einer vollständigen grafischen Benutzeroberfläche geliefert. Es ist weder nötig, Modelle in das GGUF-Format zu konvertieren, noch das Projekt aus dem Quellcode zu kompilieren.
Darüber hinaus sind in FreeToken Desktop bereits Agent-Bindings integriert: Der Nutzer wählt einfach ein Modell und eine Anwendung aus und kann sofort loslegen.
Warum das wichtig ist
AnalyseDieses System demokratisiert den Zugang zu hochleistungsfähigen KI-Modellen, indem es deren Betrieb auf erschwinglicher Standard-Hardware ermöglicht. Es könnte die Arbeitsweisen in der KI-Entwicklung grundlegend verändern und erhebliche Barrieren für Entwickler abbauen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern