LeCun miał rację: model o 109 mln parametrów przewyższył model o 72 mld
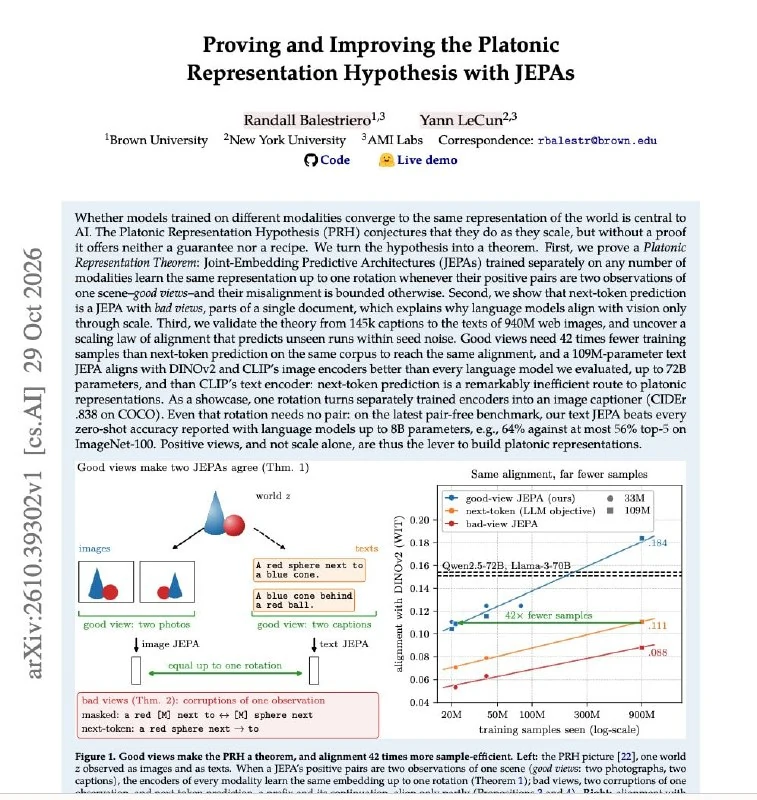
Badanie Randall Balestriero i Yann LeCuna sugeruje, że jakość i typ danych są ważniejsze niż sama wielkość modelu.
Yann LeCun miał rację, ale w tej branży nikt nie chce mówić o tym na głos.
Model z 109 mln parametrów przewyższył model z 72 mld parametrów.
Od lat LeCun twierdzi, że sama skalowalność modelu nie sprawia, że model zaczyna rozumieć świat. Meta postawiła na przeciwne podejście. W listopadzie opuścił firmę i założył własne laboratorium w Paryżu.
Niedawno opublikował dowody na swoją teorię.
Od 2024 roku branża kierowała się pomysłem, że wystarczy trenować coraz większe modele na tekście, obrazach i dźwięku, aby w końcu wytworzyły wspólne wewnętrzne przedstawienie świata. Wierzono, że wszystko rozwiązuje skala, ale tej hipotezy nigdy nie udowodniono.
Randall Balestriero i Yann LeCun ją przetestowali. Wyniki pokazują, że nie chodzi o rozmiar modelu.
Decydujące znaczenie ma to, jakie dane model otrzymuje razem.
Zdjęcie i jego opis to dwa różne sposoby przekazywania informacji o tym samym obiekcie. Modele trenowane na takich parach osiągają pożądany wynik znacznie szybciej.
Natomiast dwa akapity z jednego dokumentu nie są dwoma przedstawieniami tego samego obiektu. Modele trenowane na takich danych dochodzą do podobnego wyniku znacznie wolniej i wymagają znacznie więcej zasobów obliczeniowych.
Właśnie do tego drugiego typu należy przewidywanie następnego tokenu. Na tej zasadzie działa praktycznie każdy nowoczesny chatbot.
W eksperymentach pierwsza metoda osiągnęła porównywalny poziom zrozumienia przy zaledwie 21,6 mln przykładów. Do trenowania z przewidywaniem następnego tokenu potrzebnych było 900 mln.
Co więcej, model tekstowy z 109 mln parametrów ukształtował reprezentację świata bliższą reprezentacji modelu trenowanego na obrazach niż model językowy z 72 mld parametrów.
660 razy mniej parametrów.
Dlaczego to ważne
AnalizaTo podważa dogmat o skali i może skierować rozwój AI ku lepszym danym multimodalnym oraz wydajniejszemu treningowi.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Mistral publikuje otwarte wagi Large 4, modelu Le Chonk z 1 bilionem parametrów
Mistral udostępniła otwarte wagi flagowego modelu Large 4, nazywanego wewnątrz Le Chonk, i obniżyła ceny API.
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.
Modele Frontier
Najsilniejsza klasa sztucznej inteligencji na czele światowych badań (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), wyznaczająca granice współczesnych możliwości w zakresie rozumowania, autonomii i programowania.
LLM (Large Language Model - Duży Model Językowy)
Fundamentalna klasa architektur sieci neuronowych opartych na autoregresyjnym transformatorze, która przewiduje rozkład prawdopodobieństwa kolejnych tokenów i wykazuje emergentne właściwości abstrakcyjnego myślenia, syntezy kodu oraz wnioskowania logicznego.