Sakana AI предложили альтернативный способ обучения нейросетей, вдохновленный мозгом
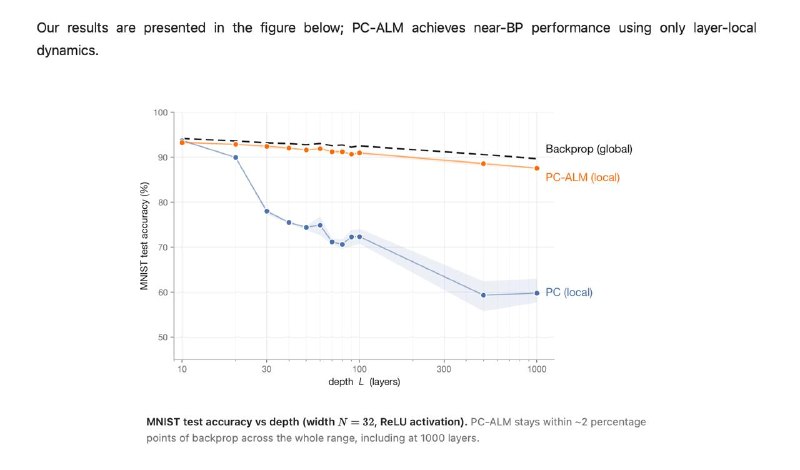
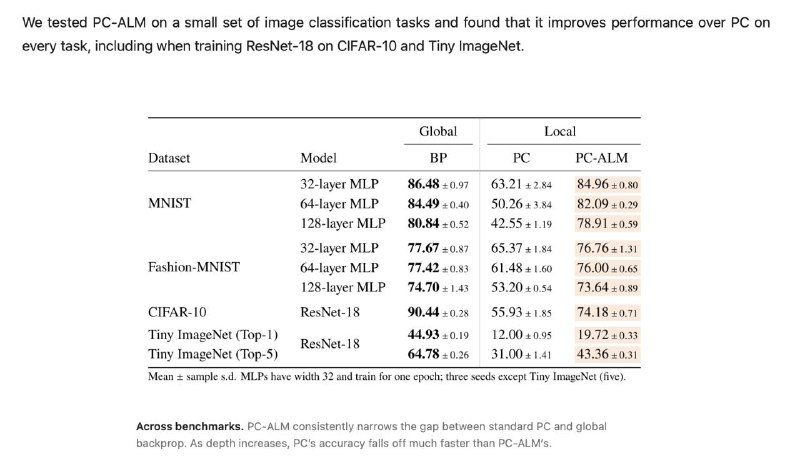
Исследователи из Sakana AI представили метод PC-ALM, который объединяет предиктивное кодирование и множители Лагранжа для локального обучения глубоких сетей, имитируя биологические процессы.
Sakana AI предложили альтернативный способ обучения нейросетей, вдохновленный мозгом
Любые современные нейросети, которыми мы пользуемся, обучаются при помощи обратного распространения ошибки (backpropagation). Алгоритм достаточно древний, придуман еще в 70-е, но до сих пор применяется повсеместно.
Однако к нему есть несколько замечаний. Главным образом дело в структуре. Backprop работает строго в три последовательные фазы: сначала сигнал проходит вперед по сети, получается ответ, затем сигнал ошибки идет от выхода обратно к входу, и только потом обновляются веса. Биологически это крайне неправдоподобно: нет механизма, который заставлял бы наши нейроны ждать, пока откуда-то, через все остальные нейроны, придет сигнал ошибки и можно будет обновиться.
Sakana AI, как известно, отличаются именно тем, что вдохновляются идеями из нейронауки. И они предлагают смотреть в сторону подхода под названием predictive coding (это термин из работ по строению зрительной коры мозга).
Обычно, когда мы обучаем нейросеть, оптимизируются только ее веса. В PC же мы оптимизируем и веса, и сами активации каждого слоя: каждый слой пытается предсказать активность следующего слоя, и наверх идет только остаток, который он не смог объяснить. Идея в том, что система должна найти локальное равновесие между ошибкой предсказания снизу и сверху, и тогда ответы сети будут хорошо предсказывать целевую переменную.
Этот подход придумали не в Sakana AI, он довольно известный. Но, к сожалению, не рабочий: в глубоких сетях сигнал просто затухает, и ничего не учится, потому что сетка не понимает, куда двигать веса.
Sakana внесли всего одно небольшое дополнение — и метод стал хорошо обучать сети до 1000 слоев. Помогло старое советское... добавление множителя Лагранжа. Еще в 1988 году Лекун показал: если записать нейросеть как задачу с ограничениями (как делает PC) и присвоить каждому ограничению множитель Лагранжа λ, то в точке равновесия λ будет в точности равен backprop-градиенту. Это математический факт, который Sakana и догадались использовать.
То есть если в ванильном PC сигнал примерный, то в подходе Sakana — PC-ALM — он на линейных сетях точно сходится к backprop-градиенту, используя только связь с соседними слоями, без единого глобального прохода.
На разных бенчмарках PC-ALM почти не отстает от backprop (разница ~2 п.п. точности на MNIST). И да, выигрыша в точности или скорости обучения над backprop нет. Выигрывать он (возможно) будет только на нейроморфном железе когда-то в будущем. Зато мы, возможно, стали на шаг ближе к тому, чтобы воссоздать процесс обучения живого мозга. Ну и просто красиво ☕️
Почему это важно
АналитикаМетод позволяет обучать нейросети локально, без глобального обратного прохода, что является ключом к созданию энергоэффективных нейроморфных чипов.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Аналоговое заземление для инженеров
Система регулярных аналоговых практик (бумажные блокноты, физические доски, прогулки без гаджетов и ручной труд) для сброса синтетической перегрузки и восстановления пластичности мозга.
Профиль Hermes: Методолог обучения и архитектура курсов
Профиль образовательного методолога Hermes: проектирование программ по таксономии Блума, микрообучение, практические воркшопы и оптимизация Completion Rate.
NotebookLM + Perplexity для работы, обучения и заработка
Что такое NotebookLM и Perplexity
GPT-6 без дообучения улучшила веса Qwen3.5-0.8B
Исследователи MIT CSAIL показали Weight-Space Programming: Astra без градиентного спуска и обучения изменила веса Qwen3.5-0.8B и улучшила её результаты на MATH-500 и GSM8K.