Recurrent Looped Transformer: Nowa koncepcja architektoniczna dla AI
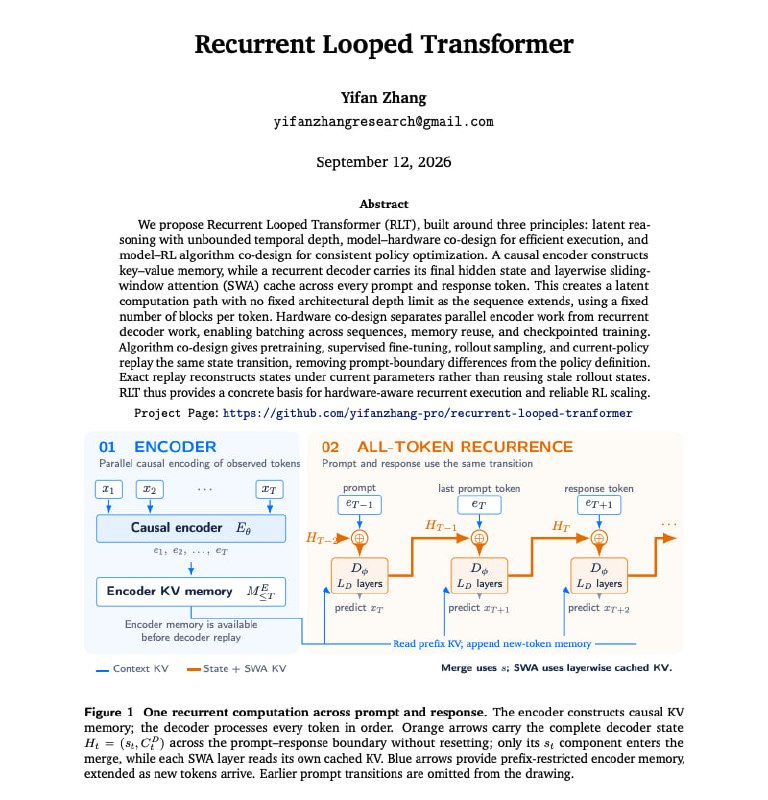
Nowy raport techniczny proponuje rozszerzenie pętli między tokenami, czyniąc dekoder rekurencyjnym dla każdego tokenu, co zwiększa głębokość obliczeniową bez wzrostu kosztów na pojedynczy token.
Looped Transformer jest obecnie jednym z najczęściej omawianych pomysłów architektonicznych w dziedzinie sztucznej inteligencji.
W nowym raporcie technicznym zaproponowano rozciągnięcie cyklu już istniejącego między tokenami. Recurrent Looped Transformer sprawia, że dekoder staje się rekurencyjny dla każdego tokenu, obejmując zarówno prompt, jak i odpowiedź.
Kodowanie przyczynowe (causal encoder) tworzy współdzieloną pamięć KV. Dla każdego nowego tokenu dekoder łączy:
- Reprezentację tego tokenu z enkodera.
- Własny końcowy stan ukryty z poprzedniego tokenu.
- Pamięć podręczną ostatnich aktywacji z przesuwającym się oknem.
Przy dekodrze składającym się z 48 warstw ścieżka obliczeń po przetworzeniu t tokenów przechodzi przez 48t bloków dekodera, choć każdy pojedynczy token nadal wykonuje stałą liczbę bloków.
Oznacza to, że głębokość obliczeń rośnie wraz z długością sekwencji, podczas gdy koszt przetwarzania pojedynczego tokenu pozostaje stały.
Ta sama transformacja stanu jest wykorzystywana podczas pre-treningu, SFT, generowania oraz powtórek w RL. Stan nie jest resetowany na granicy między promptem a odpowiedzią.
Podczas powtórek RL stany są odbudowywane przy użyciu obecnych wag modelu, zamiast ponownego wykorzystywania nieaktualnych stanów z wcześniejszych uruchomień.
Na razie jest to wyłącznie propozycja architektoniczna. Autor wyraźnie zaznacza, że poprawa rozumowania, akceleracja sprzętowa oraz skalowanie RL to cele, które nie zostały jeszcze zmierzone.
Dlaczego to ważne
AnalizaTo podejście oferuje sposób na dynamiczne skalowanie efektywnej głębokości sieci neuronowych w zależności od długości sekwencji, potencjalnie poprawiając zdolności rozumowania modeli bez liniowego zwiększania kosztów wnioskowania.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Mistrzostwo w pracy z Agentem Hermes: Kompletny przewodnik po koncepcjach, komendach i scenariuszach
Hermes to nie kolejny agent AI z zestawem integracji. To pierwszy agent, który dosłownie tworzy własne instrukcje: po każdym zadaniu rejestruje wykonane czynności, pakuje je w umiejętność (skill), dzięki czemu przy następnym uruchomieniu działa szybciej i precyzyjniej.
Hugging Face i Transformers: od uruchomienia po architekturę
Przewodnik krok po kroku dla osób chcących zrozumieć działanie współczesnych modeli językowych (BERT, GPT i innych), a także poznać sposoby ich uruchamiania, wykorzystywania oraz dostosowywania do własnych zadań na przykładzie biblioteki Transformers i platformy Hugging Face.
Pamięć krótko- i długoterminowa agentów
Architektura wielowarstwowej pamięci autonomicznych agentów. Podział na pamięć krótkoterminową (Short-Term Memory – aktywne okno kontekstowe bieżącej sesji) oraz pamięć długoterminową (Long-Term Memory – bazy danych wektorowych, pliki profilu użytkownika oraz dzienniki epizodyczne).
Erozja architektoniczna wynikająca z szybkiego kodowania
Niewidoczne gromadzenie się ukrytych sprzeczności systemowych oraz niszczenie granic architektonicznych projektu poprzez fragmentaryczne, lokalne poprawki kodu generowane przez modele językowe.