Recurrent Looped Transformer: новая идея для архитектуры ИИ
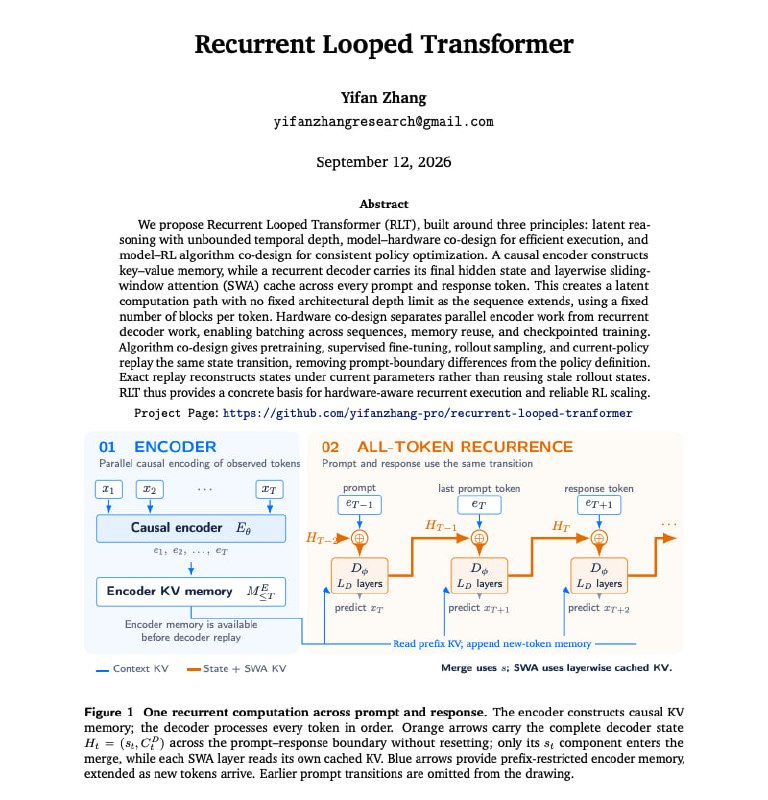
В новом техническом отчете предлагается растянуть цикл между токенами, делая декодер рекуррентным для каждого токена, что увеличивает глубину вычислений без роста стоимости обработки.
Looped Transformer — сейчас одна из самых обсуждаемых архитектурных идей.
В новом техническом отчете цикл предлагают растянуть уже между токенами. Recurrent Looped Transformer делает декодер рекуррентным для каждого токена, включая и запрос, и ответ.
Каузальный энкодер формирует общую KV-память. Для каждого нового токена декодер объединяет:
- представление этого токена из энкодера;
- собственное финальное скрытое состояние от предыдущего токена;
- кеш недавних активаций со скользящим окном.
При декодере из 48 слоев путь вычислений после t токенов проходит уже через 48t блоков декодера, хотя каждый отдельный токен все равно выполняет фиксированное число блоков.
То есть глубина вычислений растет вместе с длиной последовательности, а стоимость обработки одного токена остается постоянной.
Один и тот же переход между состояниями используется для предварительного обучения, SFT, генерации и повторного воспроизведения в RL. На границе между запросом и ответом состояние не сбрасывается.
Во время RL replay состояния заново строятся с текущими весами модели, вместо повторного использования устаревших состояний из предыдущих запусков.
Пока это именно архитектурное предложение. Автор прямо пишет, что прирост в рассуждениях, ускорение на железе и масштабирование RL — это цели, которые еще не были измерены.
Почему это важно
АналитикаЭто решение позволяет динамически увеличивать глубину нейросети в зависимости от длины последовательности, сохраняя при этом стабильную стоимость вычислений на токен.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Как правильно создавать Skills для Claude Code: от архитектуры до тестирования
Исчерпывающее инженерное руководство по разработке Skills для Claude Code: анатомия папок и SKILL.md, поэтапная загрузка (progressive disclosure), отличия от хуков и evaluation-driven подход.
Искусственный Интеллект как Резиновая Уточка (Rubber Ducking)
Современная эволюция классического инженерного метода Rubber Duck Debugging. Использование языковой модели не как генератора готовых ответов, а как терпеливого интеллектуального собеседника, которому человек поэтапно объясняет свою проблему, находя решение в процессе рассказа.
Архитектура Transformer
Архитектура нейронных сетей, представленная исследователями Google в 2017 году в статье «Attention Is All You Need». Основополагающая для всех современных языковых моделей (GPT, Claude, Gemini, Llama), которая заменила медленные рекуррентные сети и научилась параллельно обрабатывать весь текст одновременно.
Как создать собственную дизайн-систему в Claude Design: от мудборда до анимированного маскота
Полное практическое руководство по созданию бренд-дизайн-системы в Claude Design: сбор референсов, генерация 4 концепций, токенизация, стресс-тестирование и разработка анимированного SVG-маскота.