PrismML udostępnia Bonsai 2 27B: lokalny model AI o rozmiarze 5,9 GB oparty na Qwen
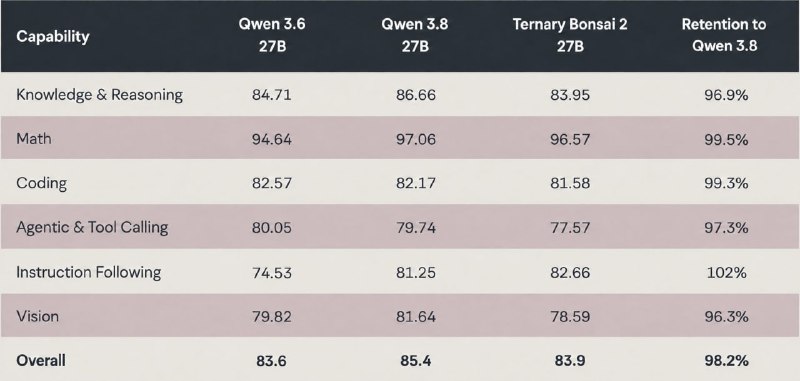
PrismML zaprezentował Bonsai 2 27B – skwantyzowany model bazujący na architekturze Qwen, który zajmuje zaledwie 5,9 GB, zachowując przy tym 98,2% wydajności oryginału.
Zespół PrismML przedstawił nowy model Bonsai 2 27B, zbudowany w oparciu o architekturę Qwen3.8 27B. Premiera ta stanowi znaczący krok naprzód w dziedzinie modeli lokalnych oraz optymalizacji zasobów.
Dzięki zastosowaniu kwantyzacji 3-bitowej rozmiar modelu został zredukowany do 5,9 GB, co oznacza, że jest on około dziewięciokrotnie mniejszy niż pełna wersja. Czyni to go idealnym rozwiązaniem do uruchamiania na urządzeniach z ograniczoną pamięcią operacyjną.
Według testów przeprowadzonych przez deweloperów, model zachowuje 98,2% wyników uzyskiwanych przez oryginalną wersję. Jednocześnie obsługuje przetwarzanie obrazów (multimodalność) oraz wywoływanie narzędzi (function calling).
Model Bonsai 2 27B jest otwartoźródłowy i dostępny na licencji Apache 2.0. Oficjalne ogłoszenie można znaleźć na stronie PrismML.
Dlaczego to ważne
AnalizaTo kluczowa wiadomość dla programistów chcących wdrażać zaawansowane modele AI lokalnie bez konieczności inwestowania w drogi sprzęt, przy jednoczesnym zachowaniu wysokiej dokładności i funkcjonalności.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Kwantyzacja (Model Quantization)
Technologia matematycznej kompresji wag i aktywacji sieci neuronowej poprzez przejście z wysokiej precyzji (FP16/BF16) do formatów o niskiej rozdzielczości (FP8, INT8, INT4, GGUF) w celu znaczącej oszczędności pamięci.
Badacze z MIT pokazali, że LLM może czytać i edytować wagi modeli bez uczenia
MIT CSAIL zaprezentował Weight-Space Programming: Astra czytała i modyfikowała wagi Qwen3.5-0.8B bez gradientowego spadku i fine-tuningu, poprawiając wyniki w benchmarkach matematycznych.
GPT-6 Astra miała zmienić wagi innego modelu AI bez doszkalania
GPT-6 Astra miała zmienić tylko 0,016% wag Qwen3.5-0.8B bez gradientów i doszkalania, poprawiając rozumowanie, wyniki matematyczne i stosowanie się do instrukcji.
AWQ i kwantyzacja GPU uwzględniająca aktywacje
Metody 4-bitowej kompresji wag modeli językowych, zoptymalizowane pod architekturę rdzeni tensorowych NVIDIA w celu maksymalizacji przepustowości oraz zachowania krytycznych kanałów aktywacji.