PrismML выпустила Bonsai 2 27B: локальная ИИ-модель на 5,9 ГБ на базе Qwen
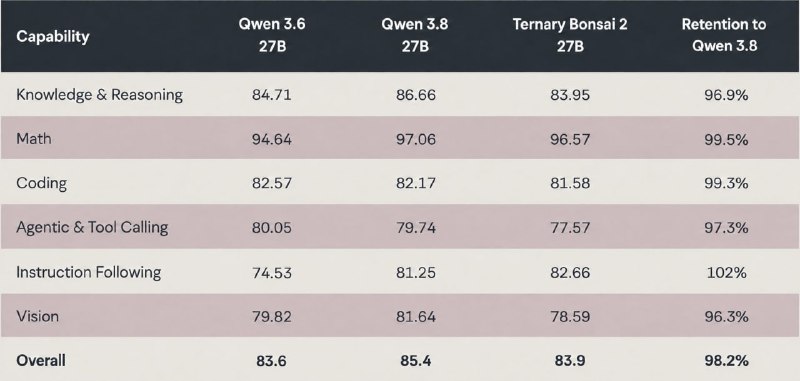
PrismML представила Bonsai 2 27B — квантованную версию модели на базе Qwen, которая занимает всего 5,9 ГБ и сохраняет 98,2% производительности оригинала.
Команда PrismML представила новую модель Bonsai 2 27B, созданную на базе архитектуры Qwen3.8 27B. Этот релиз демонстрирует значительный прогресс в сфере локальных моделей и оптимизации ресурсов.
Благодаря применению трёхбитного квантования, размер модели был уменьшен до 5,9 ГБ, что примерно в девять раз меньше полной версии. Это делает её идеальной для запуска на устройствах с ограниченной памятью.
По тестам разработчиков, модель сохраняет 98,2% результатов оригинальной модели. При этом она поддерживает работу с изображениями (мультимодальность) и вызов инструментов (function calling).
Модель Bonsai 2 27B является открытой и доступна под лицензией Apache 2.0. Официальный анонс можно посмотреть на сайте PrismML.
Почему это важно
АналитикаЭто важно для разработчиков, которые хотят внедрять мощные ИИ-модели локально без необходимости в дорогом оборудовании, сохраняя при этом высокую точность и функциональность.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
GPT-6 без дообучения улучшила веса Qwen3.5-0.8B
Исследователи MIT CSAIL показали Weight-Space Programming: Astra без градиентного спуска и обучения изменила веса Qwen3.5-0.8B и улучшила её результаты на MATH-500 и GSM8K.
AWQ & Activation-Aware GPU Quantization
Методы 4-битного сжатия весов языковых моделей, оптимизированные под архитектуру тензорных ядер NVIDIA для максимальной пропускной способности и сохранения критических каналов активации.
GGUF и Современные Стандарты Квантизации
Универсальный бинарный формат файлов для хранения и мгновенной загрузки квантизированных языковых моделей на процессорах и видеокартах в llama.cpp, Ollama и LM Studio.
GPT-6 Astra изменила веса другой ИИ-модели без дообучения
Заявлено, что GPT-6 Astra напрямую изменила 0,016% весов Qwen3.5-0.8B без градиентов и дообучения, устранив зацикливание рассуждений и улучшив математические результаты и следование инструкциям.