PrismML lanza Bonsai 2 27B: Un modelo de IA local de 5,9 GB basado en Qwen
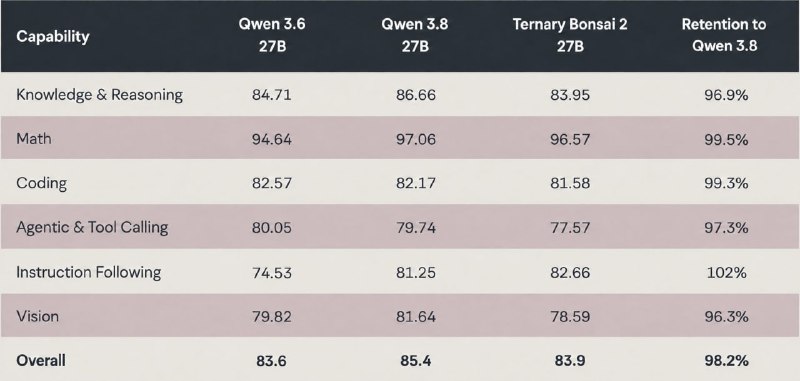
PrismML ha presentado Bonsai 2 27B, una versión cuantizada de un modelo basado en Qwen que ocupa solo 5,9 GB y mantiene el 98,2% del rendimiento del original.
El equipo de PrismML ha presentado el nuevo modelo Bonsai 2 27B, creado sobre la arquitectura Qwen3.8 27B. Este lanzamiento demuestra un progreso significativo en el campo de los modelos locales y la optimización de recursos.
Gracias al uso de cuantificación de 3 bits, el tamaño del modelo se ha reducido a 5,9 GB, lo que es aproximadamente nueve veces menos que la versión completa. Esto lo hace ideal para ejecutarse en dispositivos con memoria limitada.
Según las pruebas de los desarrolladores, el modelo conserva el 98,2% de los resultados del modelo original. Al mismo tiempo, admite el procesamiento de imágenes (multimodalidad) y la llamada de herramientas (function calling).
El modelo Bonsai 2 27B es abierto y está disponible bajo la licencia Apache 2.0. El anuncio oficial se puede ver en el sitio web de PrismML.
Por qué es importante
AnálisisEsto es crucial para los desarrolladores que buscan implementar modelos de IA potentes localmente sin hardware costoso, manteniendo al mismo tiempo una alta precisión y funcionalidad.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Investigadores del MIT muestran que un LLM puede leer y editar pesos de modelos sin entrenamiento
El equipo de MIT CSAIL presentó Weight-Space Programming: Astra leyó y modificó los pesos de Qwen3.5-0.8B sin descenso de gradiente ni fine-tuning, mejorando sus resultados en benchmarks matemáticos.
GPT-6 Astra habría modificado pesos de otro modelo de IA sin reentrenamiento
Se afirma que GPT-6 Astra modificó solo el 0,016% de los pesos de Qwen3.5-0.8B sin gradientes ni reentrenamiento, mejorando razonamiento, matemáticas y seguimiento de instrucciones.
AWQ & Activación-Consciente Cuantización de GPU
Métodos de compresión de 4 bits de los pesos de modelos de lenguaje, optimizados para la arquitectura de núcleos tensoriales de NVIDIA para máxima capacidad y preservación de canales críticos de activación.
GGUF y Estándares Modernos de Cuantización
Formato binario universal para el almacenamiento y carga instantánea de modelos de lenguaje cuantizados en CPUs y GPUs en llama.cpp, Ollama y LM Studio.