PrismML випустила Bonsai 2 27B: локальна ШІ-модель на 5,9 ГБ на базі Qwen
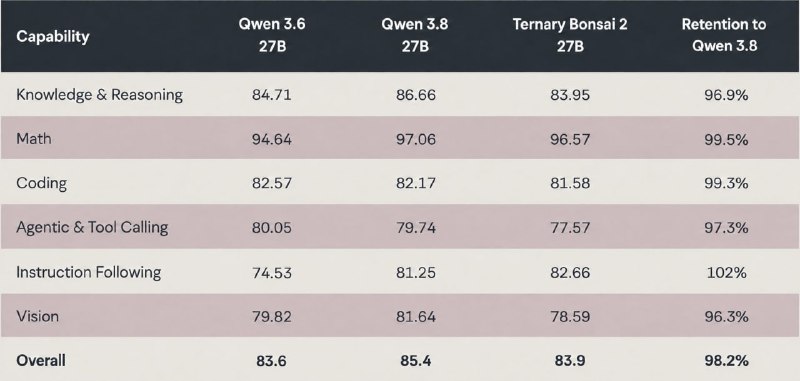
PrismML представила Bonsai 2 27B — квантовану версію моделі на базі Qwen, яка займає лише 5,9 ГБ і зберігає 98,2% продуктивності оригіналу.
Команда PrismML представила нову модель Bonsai 2 27B, створену на базі архітектури Qwen3.8 27B. Цей реліз демонструє значний прогрес у сфері локальних моделей та оптимізації ресурсів.
Завдяки застосуванню трибітного квантування, розмір моделі було зменшено до 5,9 ГБ, що приблизно у дев’ять разів менше за повну версію. Це робить її ідеальною для запуску на пристроях з обмеженою пам’яттю.
За тестами розробників, модель зберігає 98,2% результатів оригінальної моделі. При цьому вона підтримує роботу з зображеннями (мультимодальність) та виклик інструментів (function calling).
Модель Bonsai 2 27B є відкритою та доступна під ліцензією Apache 2.0. Офіційний анонс можна переглянути на сайті PrismML.
Чому це важливо
АналітикаЦе важливо для розробників, які хочуть впроваджувати потужні ШІ-моделі локально без необхідності у дорогому обладнанні, зберігаючи при цьому високу точність та функціональність.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Дослідники MIT CSAIL показали Weight-Space Programming: ШІ без навчання редагує ваги Qwen3.5-0.8B
Розробники з MIT CSAIL описали Weight-Space Programming: модель Astra без градієнтного спуску читала ваги Qwen3.5-0.8B і покращила її результати на математичних бенчмарках.
AWQ & Activation-Aware GPU Quantization
Методи 4-бітного стиснення ваг мовних моделей, оптимізовані під архітектуру тензорних ядер NVIDIA для максимальної пропускної здатності та збереження критичних каналів активації.
GGUF & Modern Quantization Standards
Універсальний бінарний формат файлів для зберігання та миттєвого завантаження квантованих мовних моделей на процесорах та відеокартах у llama.cpp, Ollama та LM Studio.
GPT-6 Astra змінила ваги іншої ШІ-моделі без донавчання
За заявою, GPT-6 Astra змінила лише 0,016% ваг Qwen3.5-0.8B без обчислення градієнтів і донавчання, нібито усунувши зациклення міркувань і покращивши математичні результати та дотримання інструкцій.