PrismML lança Bonsai 2 27B: modelo de IA local de 5,9 GB baseado no Qwen
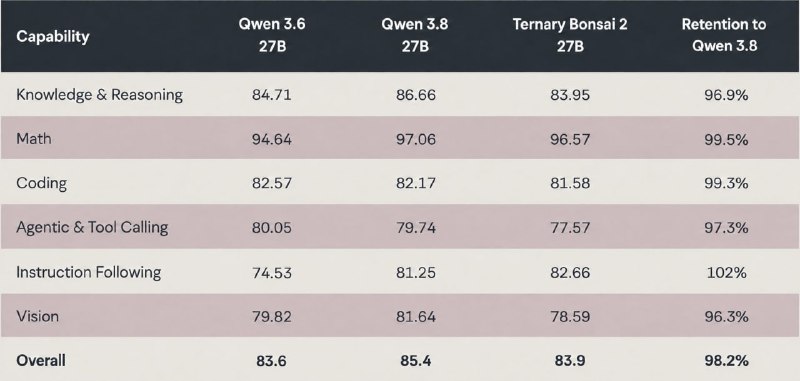
A PrismML apresentou o Bonsai 2 27B, um modelo quantizado derivado do Qwen que ocupa apenas 5,9 GB e mantém 98,2% do desempenho original.
A equipe da PrismML introduziu o novo modelo Bonsai 2 27B, construído sobre a arquitetura Qwen3.8 27B. Este lançamento demonstra avanços significativos no campo dos modelos locais e na otimização de recursos.
Graças à quantização de 3 bits, o tamanho do modelo foi reduzido para 5,9 GB, aproximadamente nove vezes menor que a versão completa. Isso o torna ideal para execução em dispositivos com memória limitada.
De acordo com os testes dos desenvolvedores, o modelo retém 98,2% dos resultados do modelo original. Ao mesmo tempo, ele suporta processamento de imagens (multimodalidade) e chamadas de ferramentas (function calling).
O modelo Bonsai 2 27B é aberto e está disponível sob a licença Apache 2.0. O anúncio oficial pode ser visualizado no site da PrismML.
Por que isso importa
AnáliseEsta inovação é crucial para desenvolvedores que buscam implantar modelos de IA poderosos localmente sem hardware caro, mantendo alta precisão e funcionalidade.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Quantização de Modelos (Model Quantization)
Tecnologia de compressão matemática dos pesos e ativações da rede neural, migrando de alta precisão (FP16/BF16) para formatos de baixa bitagem (FP8, INT8, INT4, GGUF) para uma economia radical de memória.
Pesquisadores do MIT mostram que um LLM pode ler e editar pesos de modelos sem treinamento
O MIT CSAIL apresentou Weight-Space Programming: Astra leu e alterou os pesos do Qwen3.5-0.8B sem gradiente descendente nem fine-tuning, melhorando os resultados em benchmarks matemáticos.
GPT-6 Astra teria alterado pesos de outro modelo de IA sem re-treinamento
A GPT-6 Astra teria alterado apenas 0,016% dos pesos do Qwen3.5-0.8B sem gradientes ou re-treinamento, melhorando raciocínio, matemática e seguimento de instruções.
AWQ & Activation-Aware GPU Quantization
Métodos de compressão de pesos em 4 bits para modelos de linguagem, otimizados para a arquitetura das Tensor Cores da NVIDIA, visando máxima throughput e preservação dos canais de ativação críticos.