PrismML veröffentlicht Bonsai 2 27B: Ein 5,9 GB großes lokales KI-Modell auf Qwen-Basis
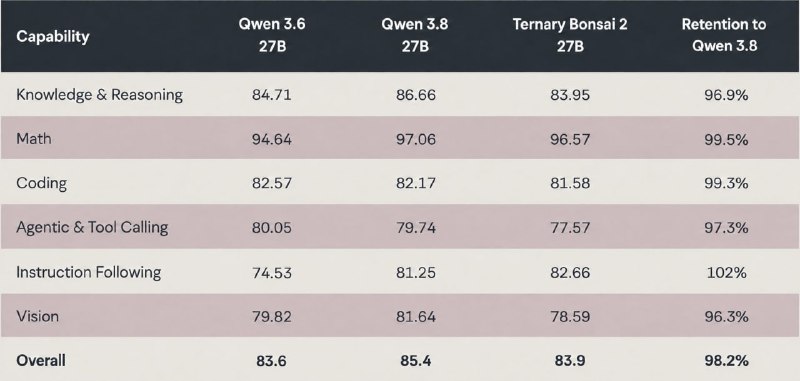
PrismML hat mit Bonsai 2 27B ein quantisiertes Modell vorgestellt, das nur 5,9 GB belegt und dabei 98,2 % der ursprünglichen Leistungsfähigkeit behält.
Das Team von PrismML hat das neue Bonsai 2 27B-Modell eingeführt, das auf der Architektur von Qwen3.8 27B basiert. Diese Veröffentlichung zeigt bedeutende Fortschritte im Bereich der lokalen Modelle und der Ressourcenoptimierung.
Dank einer 3-Bit-Quantisierung konnte die Modellgröße auf 5,9 GB reduziert werden – etwa neunmal kleiner als die Vollversion. Dies macht es ideal für den Einsatz auf Geräten mit begrenztem Speicherplatz.
Laut Tests der Entwickler behält das Modell 98,2 % der Ergebnisse des Originalmodells bei. Gleichzeitig unterstützt es Bildverarbeitung (Multimodalität) und Tool Calling (Funktionsaufrufe).
Das Bonsai 2 27B-Modell ist offen und unter der Apache-2.0-Lizenz verfügbar. Die offizielle Ankündigung kann auf der PrismML-Website eingesehen werden.
Warum das wichtig ist
AnalyseDies ist entscheidend für Entwickler, die leistungsstarke KI-Modelle lokal ohne teure Hardware bereitstellen möchten, während sie gleichzeitig hohe Genauigkeit und Funktionalität bewahren.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Quantisierung (Modell-Quantisierung)
Eine Technologie zur mathematischen Komprimierung der Gewichtungskoeffizienten und Aktivierungen neuronaler Netze durch den Übergang von hoher Präzision (FP16/BF16) zu niedrigbitigen Formaten (FP8, INT8, INT4, GGUF), um eine drastische Speichereinsparung zu ermöglichen.
MIT-Forscher zeigen: LLM kann Gewichte von Modellen ohne Training lesen und verändern
MIT CSAIL stellte Weight-Space Programming vor: Astra las und änderte Gewichte von Qwen3.5-0.8B ohne Gradientenabstieg oder Feinabstimmung und verbesserte die Mathematik-Benchmarks.
GPT-6 Astra soll Gewichte eines anderen KI-Modells ohne Nachtraining geändert haben
GPT-6 Astra soll nur 0,016 % der Gewichte von Qwen3.5-0.8B ohne Gradienten oder Nachtraining verändert haben, um Reasoning-Schleifen, Mathematikergebnisse und Instruction Following zu verbessern.
AWQ & Aktivierungsbewusste GPU-Quantisierung
4-Bit-Gewichtskomprimierungsmethoden für Sprachmodelle, optimiert für die NVIDIA-Tensor-Core-Architektur zur Maximierung des Durchsatzes und zur Bewahrung kritischer Aktivierungskanäle.