OpenAI: SWE-Bench Pro больше не подходит для оценки моделей
OpenAI объявили, что SWE-Bench Pro имеет серьезные проблемы, которые ставят под сомнение его эффективность. Они призывают к разработке новых бенчмарков для тестирования моделей.
OpenAI: SWE-Bench Pro больше не подходит для оценки моделей
Некоторое время назад OpenAI выпустили статью, в которой заявили, что один из самых популярных бенчмарков для оценки способностей моделей в кодинге – SWE-bench Verified – больше не работает. Они нашли в нем кучу проблем, сказали, что результаты на нем мало чего стоят, и призвали всех переходить на SWE-Bench Pro.
Это было в конце февраля, менее 5 месяцев назад. И угадайте, что? Сейчас OpenAI объявили, что провели аналогичный тест для SWE-Bench Pro, и он... тоже оказался сломан.
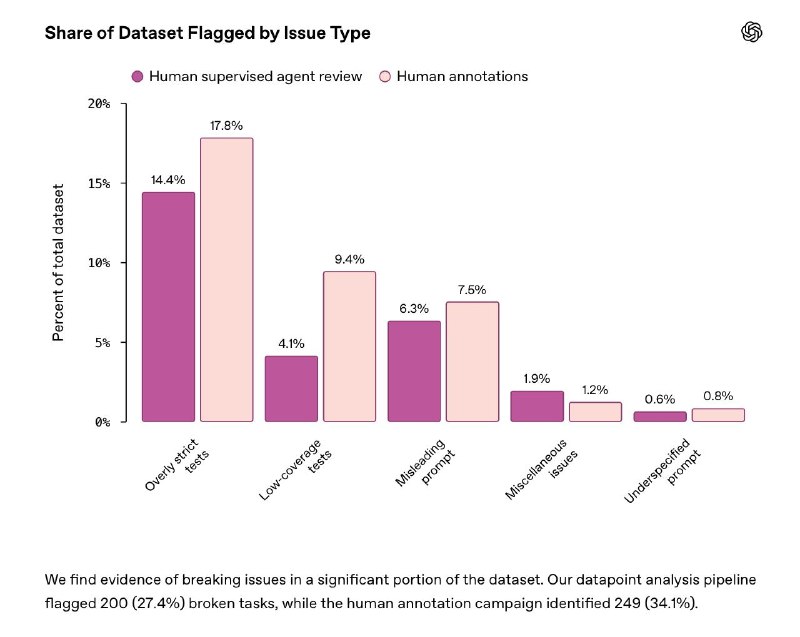
В случае с SWE-bench Verified основная проблема состояла в том, что модели воспроизводят решения "по памяти" из-за утечек задач в обучающие датасеты. Здесь же проблема скорее в самих задачах. Дело в том, что issues и PR из опенсорсных репозиториев изначально создавались для человеческого сотрудничества через долгие переписки и уточнения, а вовсе не как изолированные, чистые задачи для оценки моделей. В частности, всплыли такие проблемы:
- Слишком строгие тесты, которые навязывают конкретные детали реализации, не указанные в условии задачи, из-за чего множество функционально корректных решений отбраковываются.
- Тесты с низким покрытием, которые, наоборот, недостаточно проверяют запрошенную функциональность, из-за чего неполные решения все равно проходят.
- Вводящие в заблуждение условия, которые направляют модель к неверному поведению или прямо противоречат тому, что требуют тесты.
OpenAI оценивает, что примерно 30% задач SWE-Bench Pro сломаны (автоматический пайплайн проверки пометил как испорченные 200 задач, а кампания ручной аннотации людьми – 249 задач, то есть 34,1%). Когда 1/3 задач бенчмарка – с такими ошибками в условиях, доверять ему сложно, поэтому OpenAI формально отзывает свою прежнюю рекомендацию использовать SWE-Bench Pro и "надеется, что сообщество разработает новые бенчмарки, созданные специально для тестирования возможностей моделей".
Почему это важно
АналитикаЭто важно, поскольку проблемы с бенчмарками могут существенно повлиять на оценку эффективности AI-моделей. Отсутствие надежных инструментов для тестирования может помешать развитию технологий.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: сравнение моделей 2026
Каждые несколько недель выходит новая модель, и каждый раз те же вопросы: стоит ли переходить? что изменилось? за что платить?
Бенчмарки для агентов: GAIA и SWE-bench
Новое поколение строгих практических бенчмарков для оценки автономности искусственного интеллекта. GAIA тестирует мультимодальные задачи в открытом вебе с файлами и браузером, а SWE-bench проверяет способность агентов находить и исправлять настоящие баги в больших репозиториях GitHub.
Оценка Агентов и Бенчмаркинг SWE-bench
Методология и инфраструктура систематического измерения надежности, точности и безопасности ИИ-агентов с помощью синтетических тестов, SWE-bench и headless репозиторных симуляций.
OpenAI выпустила модель GPT-6 Cyber, которая нашла 948 уязвимостей в ядре Linux
OpenAI представила специализированную ИИ-модель GPT-6 Cyber, которая обнаружила 948 уязвимостей в ядре Linux и более 80 критических уязвимостей в Firefox.