NVIDIA lanza el modelo abierto Nemotron 3.5 Lightning para agentes de IA
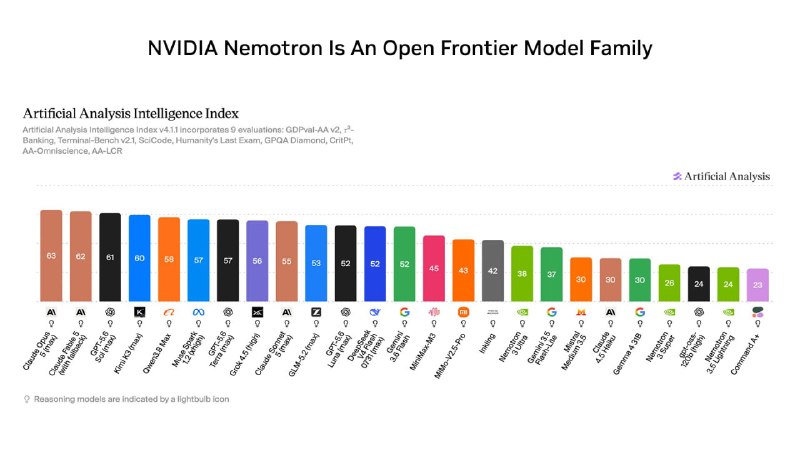
NVIDIA ha presentado un nuevo modelo abierto, Nemotron 3.5 Lightning, que ofrece alta velocidad de generación y precisión para agentes de IA.
NVIDIA ha lanzado el modelo abierto Nemotron 3.5 Lightning para agentes de IA que operan continuamente.
Este modelo cuenta con 30 mil millones de parámetros, de los cuales solo se activan 3 mil millones. Como resultado, la velocidad de generación es hasta cuatro veces mayor que la de modelos de tamaño comparable.
En PinchBench, demostró una precisión del 86% y completó 10,000 tareas un 35% más rápido que Qwen3.6 35B con precisión comparable.
El modelo se puede ajustar con datos, herramientas y flujos de trabajo personalizados. Es lo suficientemente compacto como para ejecutarse en DGX Spark.
Junto con él, NVIDIA abrió NeMo Switchyard, una biblioteca que distribuye diferentes etapas del trabajo del agente entre modelos. El razonamiento complejo y la planificación se pueden asignar a modelos avanzados, mientras que la ejecución masiva de tareas puede ser manejada por el rápido Lightning.
NVIDIA también publicó pesos, datos y recetas de entrenamiento.
Está disponible de forma gratuita a través de OpenRouter.
Por qué es importante
AnálisisEste modelo abre nuevas oportunidades para los desarrolladores de agentes de IA, permitiéndoles ajustar el modelo a sus necesidades. Su alta velocidad de generación y precisión lo hacen atractivo para una amplia gama de aplicaciones.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
JSON — Datos estructurados para programas, APIs y agentes de IA
Guía práctica y completa sobre JSON: especificación de sintaxis, serialización con parse y stringify, consumo de APIs REST, validación con JSON Schema y salidas estructuradas para LLMs.
Formato CSV: guía completa para automatizaciones y flujos de IA
Guía práctica sobre el formato CSV en flujos de IA: estándar RFC 4180, comparativa con XLSX y JSON, limpieza masiva, enriquecimiento de datos, scripts en Python y prompts para producción.
Monopolio de Nvidia y la Plataforma CUDA
Análisis del dominio tecnológico y económico de Nvidia en el mercado de inteligencia artificial. La plataforma CUDA (Compute Unified Device Architecture), creada en 2006, transformó las tarjetas gráficas de juegos en la principal herramienta computacional del planeta, dificultando a los competidores (AMD, Intel) romper esta monopolio.
Memoria de Video (VRAM) para IA
La memoria de video (Video RAM) de la GPU se utiliza para cargar los pesos de la red neuronal y la ventana de contexto. Es el principal cuello de botella de hardware: si el modelo no cabe en la VRAM, no se ejecutará o funcionará decenas de veces más lento en una CPU convencional.