NVIDIA dévoile Nemotron 3.5 Lightning, un modèle ouvert optimisé pour les agents IA
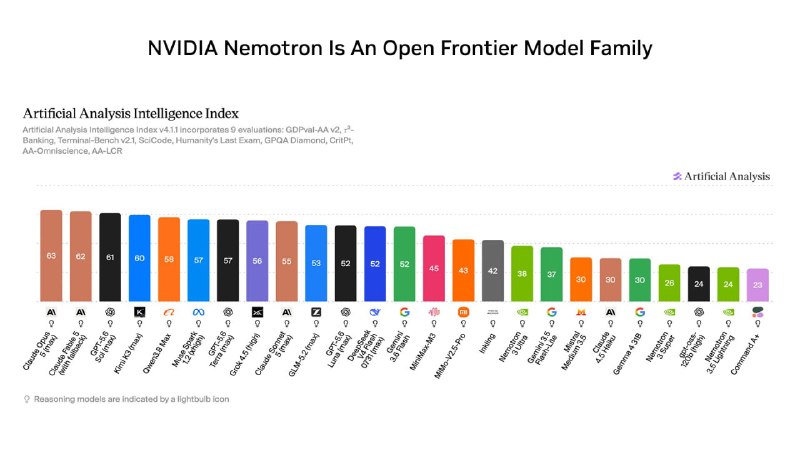
NVIDIA lance Nemotron 3.5 Lightning, un modèle à paramètres actifs réduits offrant une vitesse de génération quadruplée et une précision accrue pour les agents autonomes.
NVIDIA a publié le modèle ouvert Nemotron 3.5 Lightning, conçu spécifiquement pour les agents d'IA fonctionnant en continu.
Ce modèle se distingue par son architecture efficace : bien qu'il compte 30 milliards de paramètres au total, seuls 3 milliards sont activés simultanément. Cette conception permet d'atteindre une vitesse de génération jusqu'à quatre fois supérieure à celle des modèles comparables de taille similaire.
En termes de performance, Nemotron 3.5 Lightning a affiché une précision de 86 % sur le benchmark PinchBench. Il a également réalisé 10 000 tâches 35 % plus rapidement que Qwen3.6 35B, tout en maintenant un niveau de précision équivalent.
Le modèle est suffisamment compact pour être exécuté sur la plateforme DGX Spark et peut être affiné (fine-tuned) sur des données personnalisées, des outils spécifiques et des workflows dédiés.
Pour accompagner cette sortie, NVIDIA a ouvert NeMo Switchyard, une bibliothèque permettant de répartir les différentes étapes du travail des agents entre plusieurs modèles. Les tâches complexes de raisonnement et de planification peuvent ainsi être confiées à des modèles avancés, tandis que l'exécution massive de tâches simples est gérée par la rapidité de Lightning.
NVIDIA a également publié les poids du modèle, les données et les recettes d'entraînement sur Hugging Face. Le modèle est disponible gratuitement via OpenRouter.
Pourquoi c'est important
AnalyseCette innovation offre aux développeurs d'agents IA une flexibilité inédite grâce à l'affinage personnalisé, combinant une latence ultra-faible et une haute précision pour débloquer de nouvelles applications à grande échelle.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
JSON — données structurées pour les applications, les API et les agents IA
Guide pratique complet du format JSON : règles de syntaxe, sérialisation via parse/stringify, intégration avec les API REST, schémas JSON et sortie structurée pour l'intelligence artificielle.
Format CSV : guide complet pour l'automatisation et le travail avec l'IA
Guide pratique sur l'utilisation du format CSV dans les pipelines d'IA : spécification RFC 4180, comparaison avec XLSX et JSON, nettoyage et enrichissement massif des données, codage en Python et prompts prêts à l'emploi.
Le monopole de Nvidia et la plateforme CUDA
Analyse de la domination technologique et économique de Nvidia sur le marché de l'intelligence artificielle. Comment la plateforme logicielle CUDA (Compute Unified Device Architecture), créée en 2006, a transformé les cartes graphiques de jeu ordinaires en l'outil de calcul principal de la planète, et pourquoi il est si difficile pour les concurrents (AMD, Intel) de briser ce monopole.
Mémoire vidéo (VRAM) pour l'IA
La mémoire vidéo (Video RAM) du processeur graphique, dans laquelle sont chargés les poids des réseaux de neurones et la fenêtre de contexte. C'est le principal goulot d'étranglement matériel : si un modèle ne tient pas dans la VRAM, il ne démarrera pas ou fonctionnera dix fois plus lentement sur un processeur standard.