Método de Difusión en Máscara con Forma de Estrella
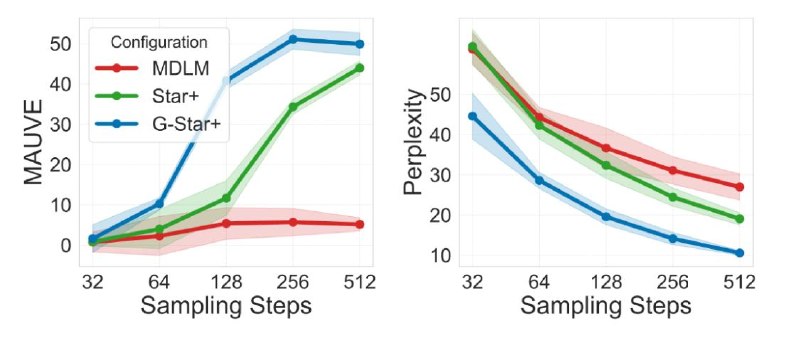
Un nuevo método de difusión en máscara con forma de estrella mejora significativamente la calidad de generación de texto mientras mantiene la velocidad. Este enfoque innovador permite un mejor manejo de la máscara de tokens y la corrección de errores.
Método de Difusión en Máscara con Forma de Estrella
En los LLM de difusión en máscara, hay un problema bastante burdo: una vez que un token está desmascarado, queda congelado. Si el modelo comete un error en un paso temprano, no puede corregir ese error y, en su lugar, intenta construir texto a su alrededor. Tales inconsistencias son particularmente notables con un pequeño número de pasos. Los métodos de remascarado existentes le dan al modelo la oportunidad de reconsiderar, pero requieren cientos de pasos, lo que socava la principal ventaja de la difusión: la velocidad.
Los autores de T-Tech, HSE y Constructor University presentaron un método en ICML donde todos los estados ruidosos dependen solo del texto limpio, no entre sí. En cada paso, el modelo predice toda la secuencia limpia, y el siguiente estado se muestrea de nuevo a partir de ella, sin heredar nada del actual: cualquier token puede volver a la máscara y reescribirse, y esto no requiere reentrenamiento. Generar desde cero no es posible: el remascarado en pasos tempranos destruye el contexto no formado, por lo que los primeros ~70% de los pasos se escriben de la manera habitual, y solo después se activa el modo de edición. Dónde editar se indica mediante un predictor de errores ligero separado, entrenado en los errores del modelo durante la generación. La principal desventaja de este enfoque es la incapacidad de insertar y eliminar tokens.
Como resultado, en 128 pasos, el método supera la calidad y diversidad de texto de los mejores enfoques anteriores con un presupuesto de 512 pasos, lo que permite generar casi tres veces más rápido (3.4 frente a 9.2 segundos en H200). El predictor de errores entrenado en textos web se transfiere a código, matemáticas y noticias sin reentrenamiento.
Por qué es importante
AnálisisEste método mejora significativamente la eficiencia de generación de texto, lo que puede ser crucial para el desarrollo de nuevas aplicaciones de IA. La velocidad y calidad de la generación abren nuevas posibilidades para el uso de LLM en varios campos.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Formatos DOCX y XLSX: cuándo se necesita un documento final completo de la IA
Guía práctica y completa sobre la generación y procesamiento de documentos DOCX y libros XLSX con IA: comparativa con Markdown y CSV, ingeniería de prompts, fórmulas y automatización en código.
Formato CSV: guía completa para automatizaciones y flujos de IA
Guía práctica sobre el formato CSV en flujos de IA: estándar RFC 4180, comparativa con XLSX y JSON, limpieza masiva, enriquecimiento de datos, scripts en Python y prompts para producción.
Binance publica una investigación sobre el robo de $6,300 millones
La investigación vincula el robo con una versión modificada de Homebrew, una entrevista falsa y el uso de una herramienta interna de IA de Binance.
Un usuario de Reddit explica por qué los límites semanales de Claude Code se consumen casi 4 veces más rápido
Un usuario de Reddit comparó el uso de tokens entre dos semanas y descubrió que ahora cada 1% del límite semanal de Claude Code genera muchos menos tokens de salida; señaló subagentes, tiempo de razonamiento y actualizaciones de interfaz como causas probables.