Вышел Grok 4.7: значительный прирост в Terminal-Bench и CursorBench
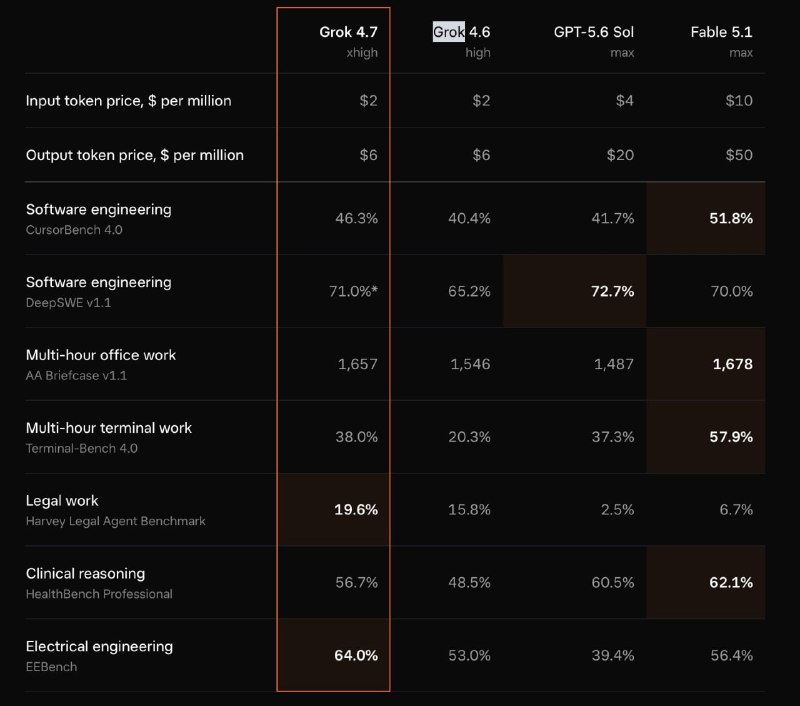
xAI выпустила Grok 4.7 с удвоением показателей в Terminal-Bench и преимуществом над GPT-5.6 Sol в CursorBench без изменения цены.
Компания xAI представила новую версию своей языковой модели — Grok 4.7. Главным достижением стал скачок в тесте Terminal-Bench, где результат вырос с 20,3% до 38%.
В бенчмарке CursorBench модель также демонстрирует преимущество над конкурентом GPT-5.6 Sol, показав результат 46,3% против 41,7%.
Важно, что ценовая политика осталась неизменной: стоимость за токены соответствует уровню предыдущей версии, Grok 4.6.
Несмотря на существенный прогресс, Grok 4.7 пока не достигает уровня Fable 5.1 в обоих указанных тестах, однако полученный прирост можно считать значительным шагом вперед.
Детали анонса доступны на официальном сайте: x.ai/news/grok-4-7
Почему это важно
АналитикаGrok 4.7 предлагает удвоенную производительность в агентных задачах без повышения стоимости, что делает его сильным конкурентом в сегменте кодинга и автоматизации.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Бенчмарки для агентов: GAIA и SWE-bench
Новое поколение строгих практических бенчмарков для оценки автономности искусственного интеллекта. GAIA тестирует мультимодальные задачи в открытом вебе с файлами и браузером, а SWE-bench проверяет способность агентов находить и исправлять настоящие баги в больших репозиториях GitHub.
Оценка Агентов и Бенчмаркинг SWE-bench
Методология и инфраструктура систематического измерения надежности, точности и безопасности ИИ-агентов с помощью синтетических тестов, SWE-bench и headless репозиторных симуляций.
Часть I. Архитектура ИИ-агентов: фундаментальные блоки
Одиннадцать фундаментальных строительных блоков современного ИИ-агента: таксономия моделей, агентный рантайм, техники промптинга, дистилляция, архитектура навыков (skills), память, function calling и FinOps.
Часть II. Архитектура ИИ-агентов: от модели до памяти и инструментов
Глубокое инженерное погружение: токенизация, KV-кэш, детерминизм сэмплинга, тренировочный стек, квантование, контекстная инженерия, стек безопасности, производственный RAG, ReAct и мультиагентные swarm-системы.