Ember-1 : le fine-tuning de Kimi K3 réduit la longueur du raisonnement de 40 %
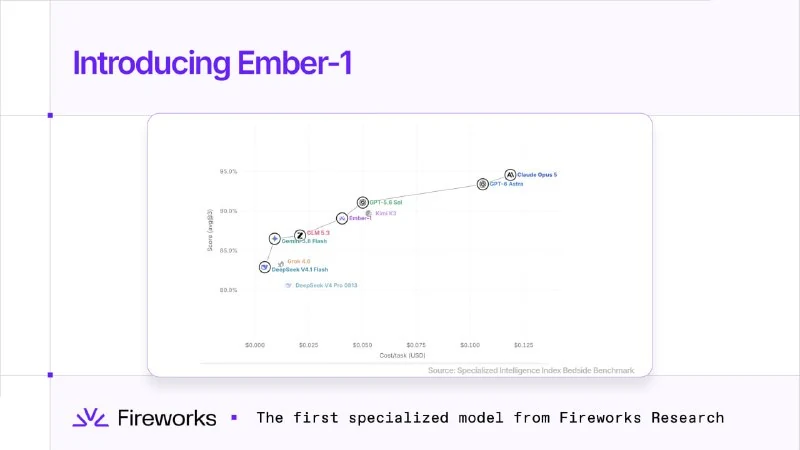
Une équipe de recherche a optimisé Kimi K3 pour raccourcir ses traces de raisonnement de 40 % sans perte de qualité. Le modèle Ember-1 est désormais disponible dans Cline.
Ember-1 fait l'objet d'une discussion active sur Hacker News.
Une équipe de recherche a effectué un fine-tuning de Kimi K3, réduisant ainsi la longueur de ses traces de raisonnement d'environ 40 %.
La qualité des résultats est restée identique, tandis que le modèle est devenu environ 40 % plus rapide et moins coûteux.
Cet exemple illustre parfaitement la stratégie pertinente pour construire des LLMs de pointe aujourd'hui. Avec quelques dizaines de millions de dollars, il n'est pas nécessaire d'entraîner un nouveau modèle depuis zéro. Il est souvent plus efficace de partir d'un modèle existant déjà performant et d'investir ce budget dans son fine-tuning.
Ember-1 est déjà disponible dans Cline, y compris via la nouvelle application desktop.
Pourquoi c'est important
AnalyseCe cas démontre que les LLMs de pointe peuvent être améliorés en affinant des modèles existants plutôt qu'en entraînant à partir de zéro, offrant ainsi une inférence plus rapide et économique.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
RAG vs Fine-Tuning (L'éternel dilemme de l'implémentation de l'IA)
Un choix architectural fondamental pour les entreprises. RAG (recherche documentaire en temps réel lors de la requête) contre Fine-Tuning (modification des poids du modèle via apprentissage supplémentaire). Critères de sélection entre l'actualité des faits et un style comportemental spécifique.
Fine-Tuning
Processus d'adaptation d'un grand modèle pré-entraîné à une tâche ou un style spécifique à l'aide d'un petit jeu de données de haute qualité (Supervised Fine-Tuning, SFT). Permet d'apprendre à l'IA la terminologie médicale, le ton corporatif ou le formatage de code spécifique en quelques heures.
Qwen4-Max est disponible : 50 % moins de tokens et un coût par tâche réduit
Qwen4-Max introduit une architecture MoE, une fenêtre de contexte d’un million de tokens et une prise en charge intégrée des images.
Partie I. Architecture des agents IA : les blocs fondamentaux
Dix blocs fondamentaux d'un agent moderne : taxonomie des modèles, boucle d'exécution (runtime), techniques de prompting, distillation, compétences (skills), mémoire, appels de fonctions et économie unitaire.