Architektura Qwen-4: Nowe osiągnięcia w dziedzinie sztucznej inteligencji
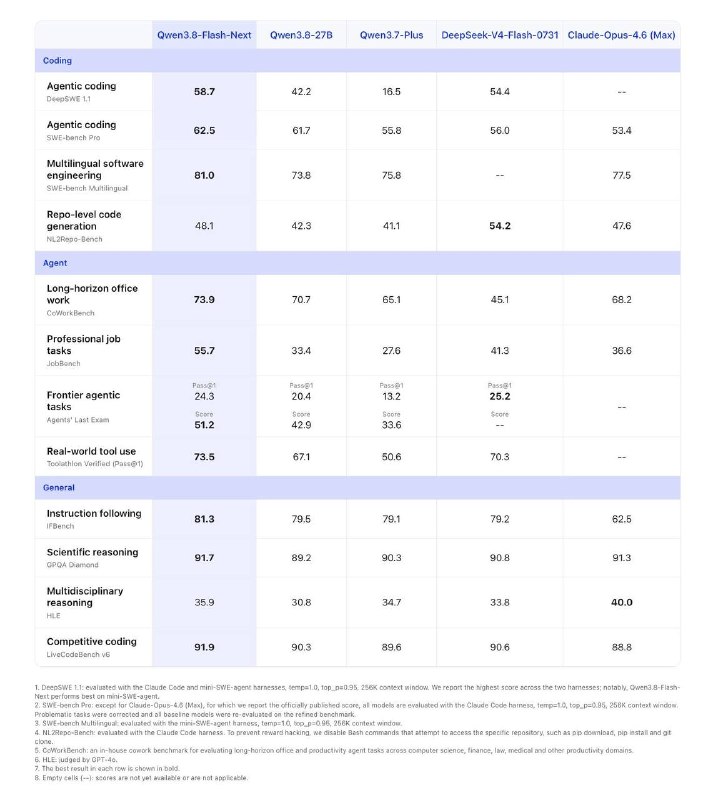
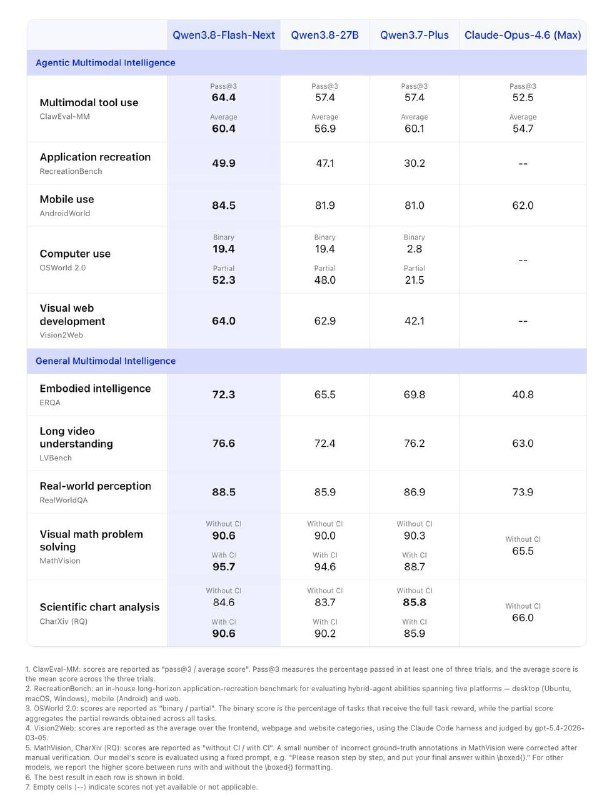
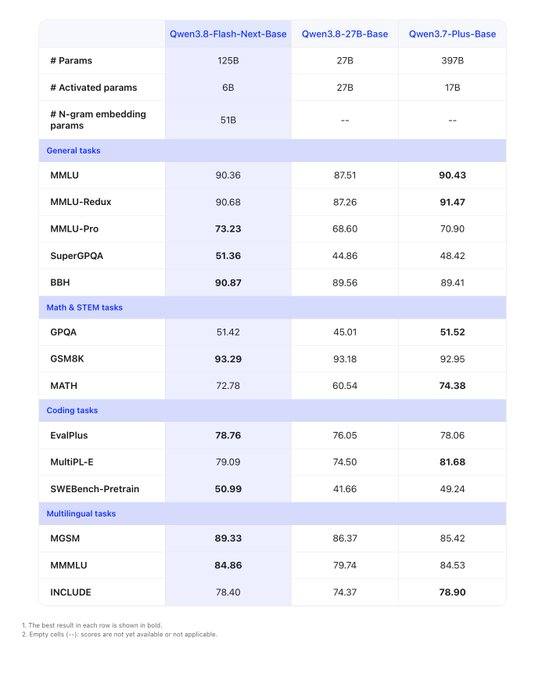
Model Qwen-4 zapowiada znaczące ulepszenia dzięki nowym technologiom, oferując wysoką wydajność przy jednoczesnym zmniejszeniu zużycia zasobów. Nadchodząca premiera Qwen3.8-Flash-Next stanowi pierwszy krok ku nowej generacji architektury.
Architektura Qwen-4: Nowe osiągnięcia w dziedzinie sztucznej inteligencji
Firma Model Scope rozpoczęła odliczanie do premiery modelu Qwen3.8-Flash-Next. Jego debiut nastąpi już jutro i będzie to pierwszy model oparty na architekturze nowej generacji, która stanowić będzie również podstawę dla przyszłego Qwen-4.
Kluczowe cechy Qwen-3.8 Flash-Next
Model ten wykorzystuje architekturę MoE (Mixture of Experts) z tablicą N-gram o rozmiarze 125B + 51B (przy aktywnych jedynie 6B parametrach), przewyższając Opus 4.6 Max w 8 z 9 testów benchmarkowych! Prześciga on również Qwen3.8-27B oraz DeepSeek-V4-Flash, a koszty jego szkolenia były dziewięciokrotnie niższe niż w przypadku Qwen3.7-Plus.
Główne innowacje w architekturze
Osadzenia N-gram (N-gram embeddings): Jest to tabela indeksowana nie pojedynczym tokenem, ale krótkimi sekwencjami. Model zapamiętuje typowe lokalne kombinacje tokenów bezpośrednio jako wektory, co redukuje obliczenia związane z tokenami i zwiększa ogólną pojemność modelu.
Gated DeltaNet + Qwen Sparse Attention: Model wybiera istotne bloki kontekstu i pracuje wyłącznie z nimi. Gated DeltaNet to mechanizm liniowej uwagi (linear attention) z bramkami kontrolującymi, co model pamięta, a co zapomina. Wynik: przy kontekście 1M tokenów faza prefill stała się 7,6 raza szybsza, a faza dekodowania 4,9 raza szybsza.
Połączenia rezydualne z bramkowaniem (Gated Residual connections): Bramki w połączeniach rezydualnych decydują, ile informacji ma zostać przekazanych dalej.
Optymalizator Muon: Ten nowy optymalizator zapewnia dziewięciokrotne oszczędności w kosztach szkolenia modelu.
Podsumowanie
W rezultacie szkolenie jest tańsze, liczba parametrów większa, a obliczenia na token mniejsze. To kolejne osiągnięcie chińskiego sektora open-source.
Dlaczego to ważne: Ta wiadomość jest istotna, ponieważ nowa architektura Qwen-4 może fundamentalnie zmienić podejścia do rozwoju modeli AI, redukując koszty szkolenia i jednocześnie zwiększając wydajność.
Dlaczego to ważne
AnalizaNowa architektura Qwen-4 może fundamentalnie zmienić krajobraz rozwoju modeli AI, drastycznie obniżając koszty szkolenia przy jednoczesnym wzroście wydajności. Stanowi to kolejny dowód na rosnącą konkurencyjność ekosystemu open-source.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
GPT-6 Astra miała zmienić wagi innego modelu AI bez doszkalania
GPT-6 Astra miała zmienić tylko 0,016% wag Qwen3.5-0.8B bez gradientów i doszkalania, poprawiając rozumowanie, wyniki matematyczne i stosowanie się do instrukcji.
Przewodnik po promptach dla modeli generatywnych GPT Image
Modele generowania obrazów gpt-image od OpenAI zostały zaprojektowane w celu tworzenia wizualizacji o jakości produkcyjnej oraz umożliwienia pełnej kontroli nad procesami twórczymi. Są one odpowiednie zarówno dla profesjonalnych projektantów...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: porównanie modeli na rok 2026
Co kilka tygodni pojawia się nowy model, a za każdym razem padają te same pytania: czy warto przejść? Co się zmieniło? Za co płacić?
Binance publikuje śledztwo w sprawie kradzieży 6,3 mld USD
Śledztwo wiąże kradzież ze zmodyfikowanym Homebrew, fałszywą rozmową kwalifikacyjną i wykorzystaniem wewnętrznego narzędzia AI Binance.