Arquitetura Qwen-4: Novos Avanços na IA
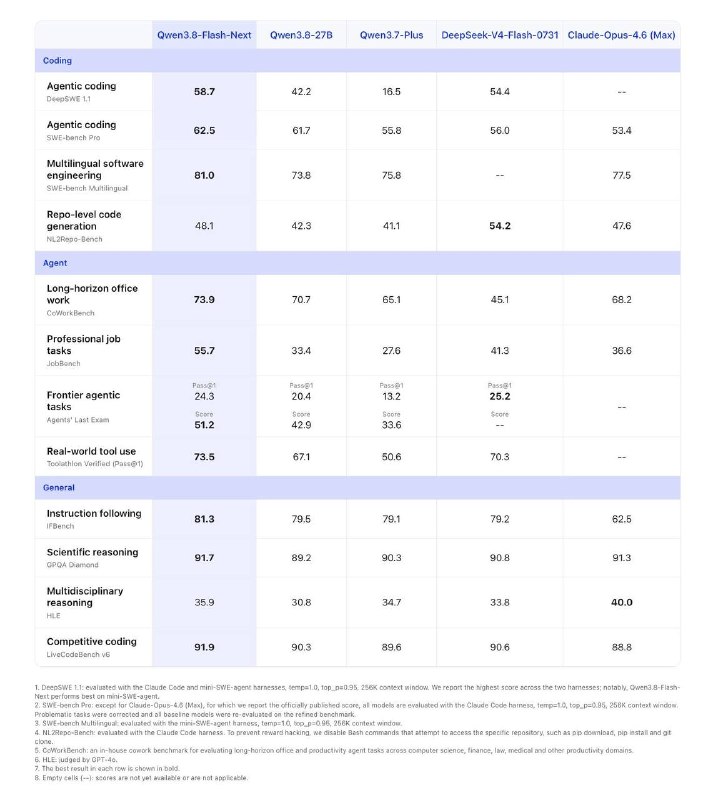
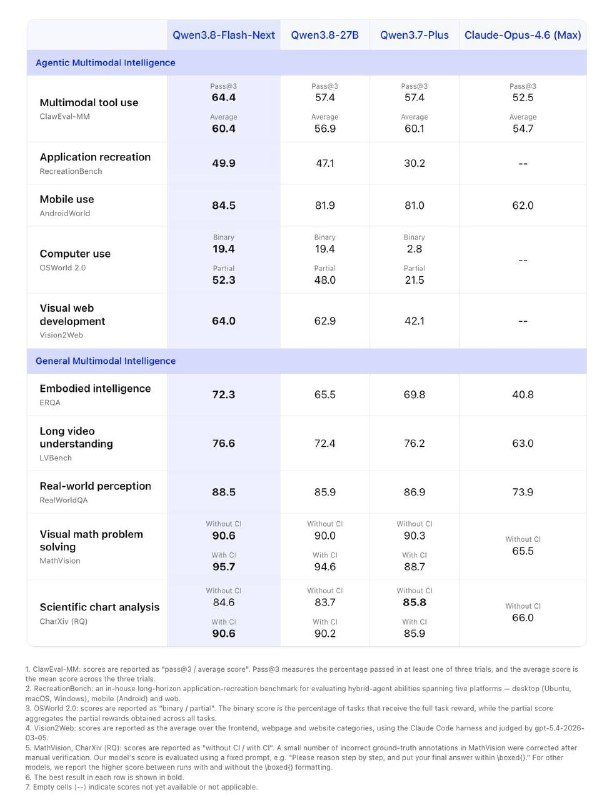
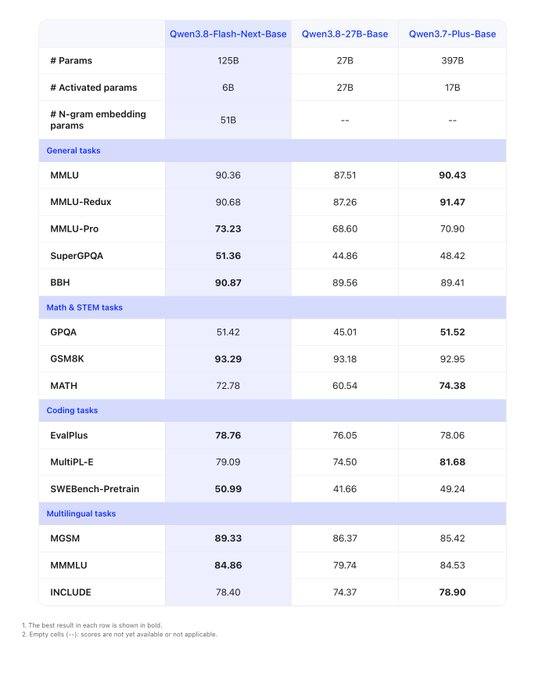
O modelo Qwen-4 promete melhorias significativas sobre as versões anteriores graças a novas tecnologias. Pesquisas indicam que a nova arquitetura entrega alto desempenho e economia de recursos.
Arquitetura Qwen-4: Novos Avanços na IA
A Model Scope iniciou a contagem regressiva para o lançamento do Qwen3.8-Flash-Next. Seu lançamento ocorrerá em um dia, sendo este o primeiro modelo construído sobre a arquitetura de próxima geração, que também servirá como base para o Qwen-4.
Principais Características do Qwen-3.8 Flash-Next
Este modelo apresenta uma configuração MoE 125B + tabela N-gram de 51B (com apenas 6B ativos), superando o Opus 4.6 Max em 8 dos 9 benchmarks! Ele também supera o Qwen3.8-27B e o DeepSeek-V4-Flash, enquanto os custos de treinamento foram 9 vezes mais baratos do que os do Qwen3.7-Plus.
Principais Inovações na Arquitetura
Embeddings N-gram: Esta é uma tabela indexada não por um único token, mas por sequências curtas. O modelo memoriza combinações locais típicas de tokens diretamente como vetores, reduzindo os cálculos de tokens e aumentando a capacidade geral do modelo.
Gated DeltaNet + Qwen Sparse Attention: O modelo seleciona blocos de contexto relevantes e trabalha apenas com eles. O Gated DeltaNet é um mecanismo de atenção linear com portões que controlam o que o modelo lembra e o que esquece. Resultado: em um contexto de 1M, o prefill ficou 7,6 vezes mais rápido e o decode 4,9 vezes mais rápido.
Conexões Residuais com Portões (Gated): Os portões nas conexões residuais determinam quanto informação deve ser transmitida.
Otimizador Muon: Este novo otimizador proporciona uma economia de 9 vezes nos custos de treinamento.
Conclusão
Como resultado, o treinamento é mais barato, há mais parâmetros e menos computações por token. Este é mais um avanço da tecnologia open-source chinesa.
Por que isso importa
AnáliseEsta notícia é significativa, pois a nova arquitetura do Qwen-4 pode mudar fundamentalmente as abordagens para o desenvolvimento de modelos de IA, reduzindo os custos de treinamento e aprimorando o desempenho.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
GPT-6 Astra teria alterado pesos de outro modelo de IA sem re-treinamento
A GPT-6 Astra teria alterado apenas 0,016% dos pesos do Qwen3.5-0.8B sem gradientes ou re-treinamento, melhorando raciocínio, matemática e seguimento de instruções.
Guia de prompts para modelos generativos GPT Image
Os modelos de geração de imagens gpt-image da OpenAI foram criados para obter visuais de qualidade de produção e processos criativos totalmente controláveis. São adequados tanto para design profissional...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Comparação de Modelos 2026
A cada poucas semanas, surge um novo modelo, e sempre as mesmas perguntas: vale a pena migrar? O que mudou? Pelo que pagar?
Binance publica investigação sobre roubo de US$ 6,3 bilhões
A investigação relaciona o roubo a um Homebrew modificado, a uma entrevista falsa e ao uso de uma ferramenta interna de IA da Binance.