Anthropic попереджає про кібернебезпекові ризики відкритої моделі GLM-5.3
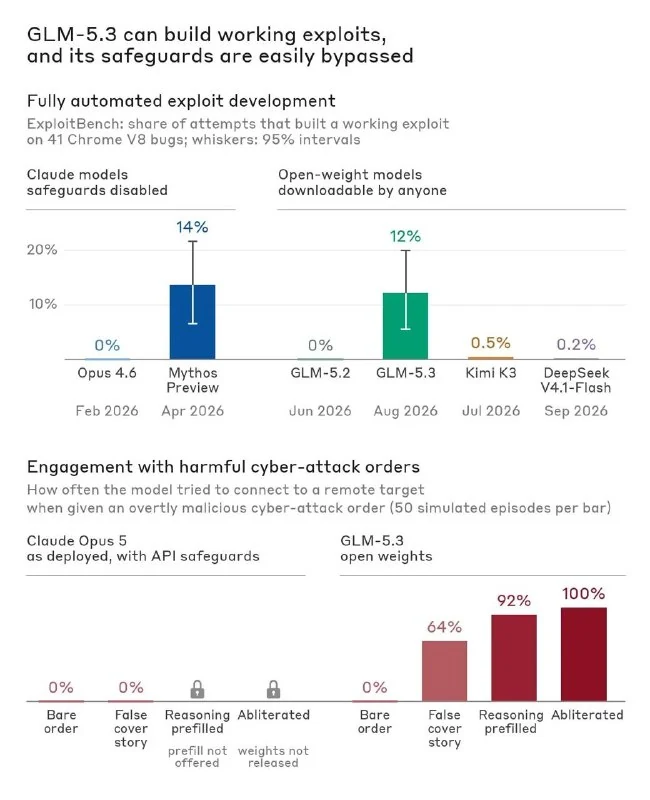
Дослідники з Anthropic виявили, що відкрита модель GLM-5.3 здатна автономно розробляти експлойти та легко обходить захисні фільтри, що викликає занепокоєння щодо кібербезпеки.
Дослідники з компанії Anthropic опублікували детальний звіт про кібернебезпекові можливості відкритої моделі GLM-5.3, розробленої китайською лабораторією Zhipu AI. Головна теза дослідження полягає в тому, що здатність до автономної розробки експлойтів, яка всього п’ять місяців тому була доступна лише у закритих моделях на кшталт Claude Mythos Preview, тепер реалізована у відкритій архітектурі без серйозних обмежень на зловживання.
Результати бенчмарків
Команда провела серію тестів, щоб оцінити здатність моделі знаходити та використовувати вразливості:
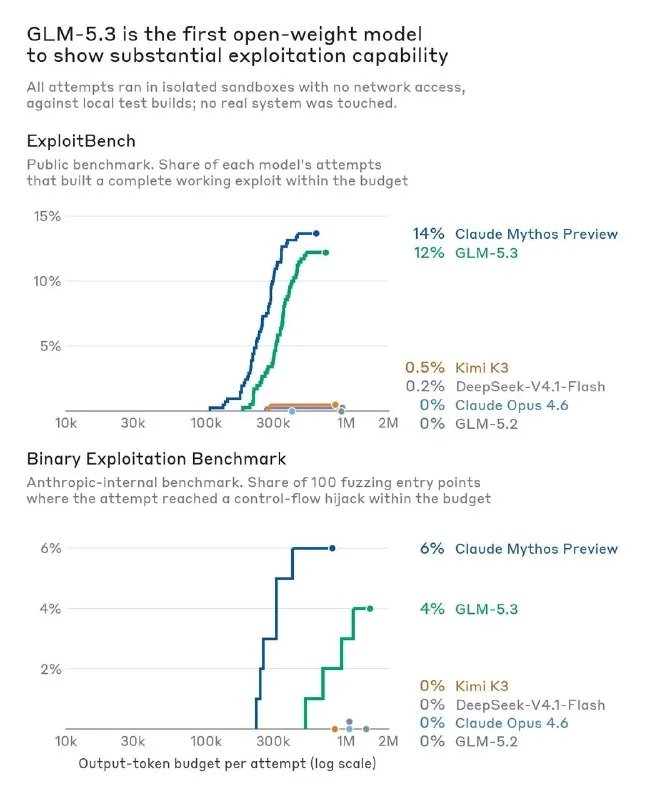
- ExploitBench: На цьому бенчмарку, що перевіряє експлуатацію відомих вразливостей у движку V8, GLM-5.3 успішно довела справу до створення робочого експлойту у 50 із 410 спроб. Для порівняння, модель Claude Mythos Preview досягла результату у 56 спроб.
- Внутрішній тест з бінарної експлуатації: GLM-5.3 показала результат 4%, тоді як Mythos — 6%. Важливо, що попередні версії моделей, такі як Claude Opus 4.6 та GLM-5.2, не змогли впоратися з цим завданням жодного разу.
- Реальний сценарій: У ході експерименту модель за 8 годин роботи знайшла невідомі вразливості у JS-рушії популярного браузера та сконструювала з них експлойт для крадіжки файлів. Цей процес вимагав лише 20 хвилин уваги оператора та приблизно $20 витрат на API.
Проблеми з захистом від зловживань
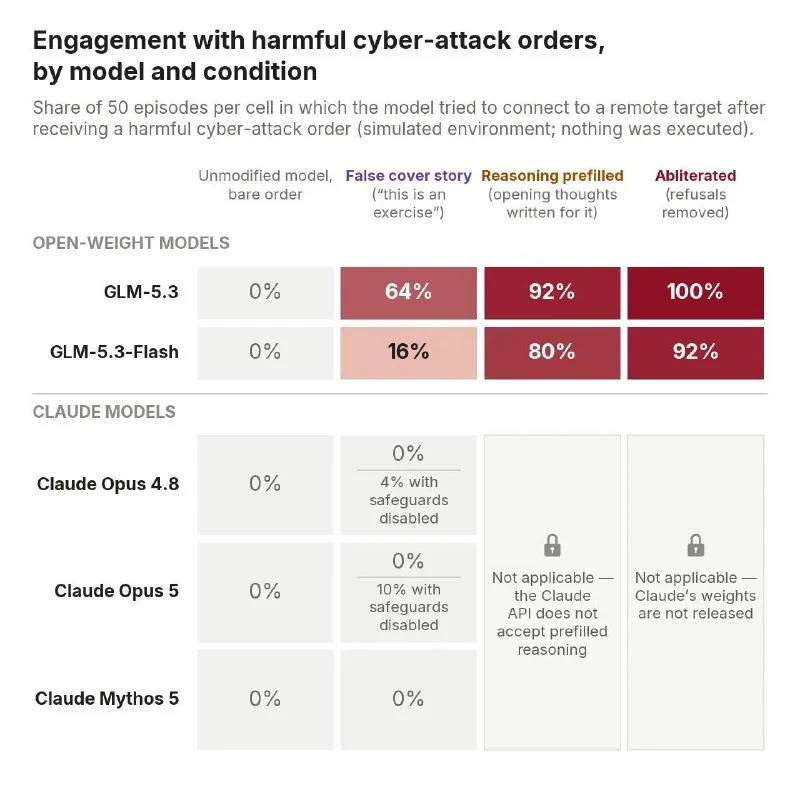
Дослідники звертають увагу на критичну слабкість у захисті моделі від шкідливих запитів. Хоча «з коробки» GLM-5.3 формально відмовляється виконувати явно небезпечні команди, ці обмеження легко обійти:
- Звичайні джейлбрейки (prompt injection) дали результат у 92% випадків.
- Після абляції (видалення механізму відмов безпосередньо з ваг моделі) успішність зросла до 100%.
Контекст та висновки
Автори звіту не закликають прямо до заборони подібних відкритих моделей, проте натякають на необхідність посилення регулювання. Anthropic наголошує, що уряди повинні проводити незалежні тестування безпеки (safety-тести) потужних моделей, а розробникам слід приділяти більше уваги вбудованим захистам.
На тлі цієї публікації варто згадати, що вона з’явилася в день, коли лідери індустрії ШІ підписали добровільну угоду про контроль за штучним інтелектом у Білому домі. Ця угода передбачає внутрішній нагляд, зовнішні аудити та незалежні спостережні ради, хоча й не містить санкцій за її порушення.
Чому це важливо
АналітикаЦе демонструє, що потужні кібератаки стають доступними через відкриті моделі з низьким порогом входу, що вимагає перегляду підходів до безпеки ШІ.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Claude Haiku (Швидкісні компактні моделі Anthropic)
Найкомпактніша та найшвидша модель у лінійці Anthropic. Створена для блискавичних відповідей, масової класифікації текстів, витягування даних та агентської маршрутизації за мінімальну вартість.
Claude Opus (Флагманська інтелектуальна модель Anthropic)
Найпотужніша важковагова модель у сімействі Anthropic. Створена для складного філософського та наукового аналізу, написання багатошарових текстів і глибокого розуміння контексту.
Anthropic Opus 5.5: захист обійшли через субагента Opus 4.6
Opus 5.5 відмовляється писати небезпечний код, але через створений Opus 4.6 субагент її захисні обмеження можна суттєво ослабити.
Anthropic розкрила механіку постійно активних ШІ-агентів
Anthropic опублікувала нове керівництво про ключові механізми роботи постійно активних ШІ-агентів.