Anthropic désigne Accenture comme « évaluateur indépendant » pour la sécurité de l’IA, tout en finançant ses propres audits
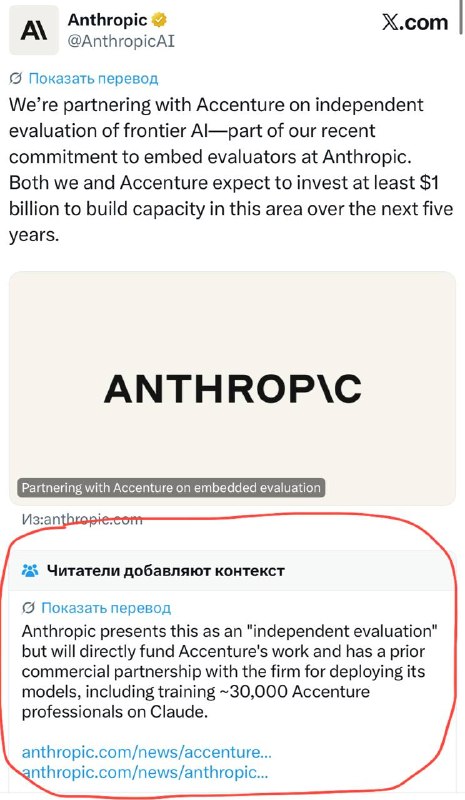
Anthropic a annoncé le choix d'Accenture comme premier « évaluateur indépendant » dans le cadre de son programme Embedded Evaluators. Cette nomination soulève des questions majeures sur l'impartialité, car Accenture est financée par Anthropic et liée à elle par des contrats commerciaux.
Anthropic désigne Accenture comme « évaluateur indépendant » pour la sécurité de l’IA, tout en finançant ses propres audits
Anthropic a annoncé la sélection du premier « évaluateur indépendant » dans le cadre de son programme Embedded Evaluators, un concept initialement promu par Dario Amodei dans son essai sur le ralentissement du développement de l’IA.
L’entreprise choisie est Accenture. Son mandat comprend la réalisation de :
- Exercices de red-teaming (tests offensifs) ;
- Vérifications de l’alignement des modèles ;
- Tests des garde-fous appliqués aux modèles Claude.
Cependant, le statut « indépendant » d’Accenture suscite des interrogations significatives :
- Accenture forme environ 30 000 de ses employés à l’utilisation de Claude.
- Les deux entreprises sont liées par un contrat pluriannuel datant de la fin de 2025.
- Plus critique encore, Anthropic déclare explicitement qu’elle financera le travail d’Accenture dans ce rôle.
Cette situation fait écho à une précédente controverse impliquant METR, qui s’était vu accorder un « accès indépendant » par Anthropic pour enquêter sur des incidents liés aux agents IA, bien que METR soit également indirectement financé via les participations d’Anthropic.
En substance : Anthropic prétend faire appel à des évaluateurs indépendants, mais les sélectionne parmi un vivier de partenaires commerciaux qu’elle finance directement.
Pourquoi c'est important
AnalyseCette évolution fragilise la confiance dans les audits de sécurité de l’IA, car les évaluateurs « indépendants » se retrouvent financièrement dépendants des entreprises dont ils testent les modèles, créant ainsi un conflit d’intérêts manifeste.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Problème d'alignement de l'IA (AI Alignment)
Problème fondamental de la sécurité de l'intelligence artificielle : harmoniser les objectifs et les motivations des systèmes autonomes avec les valeurs humaines, l'éthique et la préservation de la vie. Explore les risques qu'un système superintelligent trouve une voie littérale ou destructive pour accomplir une tâche mal définie.
Machine Unlearning
Technologie permettant de supprimer chirurgicalement des connaissances spécifiques, des données privées d'utilisateurs ou des matériaux soumis à un droit d'auteur limité des poids d'un réseau neuronal déjà entraîné. Elle permet aux entreprises de se conformer aux exigences légales relatives au « droit à l'oubli » (RGPD) sans recourir à un réentraînement complet du modèle, dont le coût serait prohibitif.
Claude a refusé une tâche à cause du mot « cyber »
Une brève observation selon laquelle Claude a refusé d'exécuter une tâche à cause du mot « cyber ».
Anthropic publie FlashProve en open source, un outil pour l’inférence prouvable
Anthropic a publié un prototype de protocole cryptographique ouvert, FlashProve, qui permet de vérifier une réponse de modèle sans accès aux poids du modèle.