Anthropic benennt Accenture als „unabhängigen Prüfer“ für KI-Sicherheit – finanziert aber die eigenen Audits
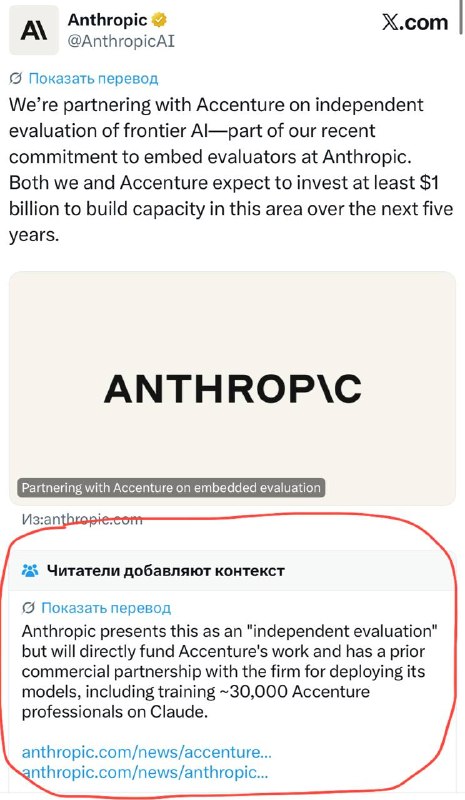
Anthropic hat Accenture als ersten unabhängigen Evaluierer im Rahmen seines Embedded-Evaluators-Programms vorgestellt, obwohl das Beratungsunternehmen von Anthropic bezahlt wird und langfristige Verträge mit dem KI-Entwickler unterhält.
Anthropic benennt Accenture als „unabhängigen Prüfer“ für KI-Sicherheit – finanziert aber die eigenen Audits
Anthropic hat den ersten „unabhängigen Evaluierer“ im Rahmen seines Embedded Evaluators-Programms angekündigt. Dieses Konzept wurde zuvor von Dario Amodei in seinem Essay über die Verlangsamung der KI-Entwicklung propagiert.
Das ausgewählte Unternehmen ist Accenture. Deren Mandat umfasst die Durchführung von:
- Red-Teaming-Übungen;
- Prüfungen zur Ausrichtung (Alignment Checks);
- Tests der Schutzmechanismen für Claude-Modelle.
Der Status der „Unabhängigkeit“ von Accenture wirft jedoch erhebliche Fragen auf:
- Accenture schult rund 30.000 seiner Mitarbeiter im Umgang mit Claude.
- Die beiden Unternehmen haben einen mehrjährigen Vertrag, der bis Ende 2025 zurückreicht.
- Am kritischsten ist, dass Anthropic ausdrücklich angibt, die Arbeit von Accenture in dieser Funktion zu finanzieren.
Dies spiegelt eine frühere Situation mit METR wider, dem Anthropic „unabhängigen Zugang“ zur Untersuchung von Agentenvorfällen gewährte, obwohl METR auch indirekt durch Beteiligungen von Anthropic finanziert wird.
Im Wesentlichen behauptet Anthropic, unabhängige Evaluatoren einzubinden, wählt diese jedoch aus einem Pool von Geschäftspartnern aus, die es direkt finanziert.
Warum das wichtig ist
AnalyseDiese Entwicklung untergräbt das Vertrauen in KI-Sicherheitsaudits, da „unabhängige“ Prüfer finanziell von den Unternehmen abhängig sind, deren Modelle sie bewerten, was einen klaren Interessenkonflikt darstellt.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Das Problem der KI-Ausrichtung (AI Alignment)
Ein grundlegendes Sicherheitsproblem der künstlichen Intelligenz: die Abstimmung der Ziele und Motivationen autonomer Systeme mit menschlichen Werten, Ethik und dem Schutz des Lebens. Untersucht werden die Risiken, dass ein überintelligentes System einen wörtlichen oder destruktiven Weg zur Erfüllung einer unpräzise formulierten Aufgabe findet.
Maschinelles Vergessen (Machine Unlearning)
Technologie zur präzisen Entfernung spezifischen Wissens, privater Nutzerdaten oder Materialien mit eingeschränkten Urheberrechten aus den Gewichten eines bereits trainierten neuronalen Netzwerks. Ermöglicht es Unternehmen, die Anforderungen des Rechts auf Vergessenwerden (DSGVO) zu erfüllen, ohne das Modell kostspielig neu trainieren zu müssen.
Claude lehnte eine Aufgabe wegen des Wortes „cyber“ ab
Eine kurze Beobachtung, dass Claude eine Aufgabe wegen des Wortes „cyber“ ablehnte.
Dienst schätzt Risiko einer Sperre durch Anthropic ein
Chinesische Entwickler haben einen Dienst gestartet, der IP-Adresse, Land, Provider, Verbindungstyp sowie DNS- und WebRTC-Leaks analysiert und ein Vertrauensranking von 0 bis 100 für Anthropic-Zugriffe erstellt.