Alibaba officialise la famille de modèles Qwen4 et présente la puce Zhenwu V900
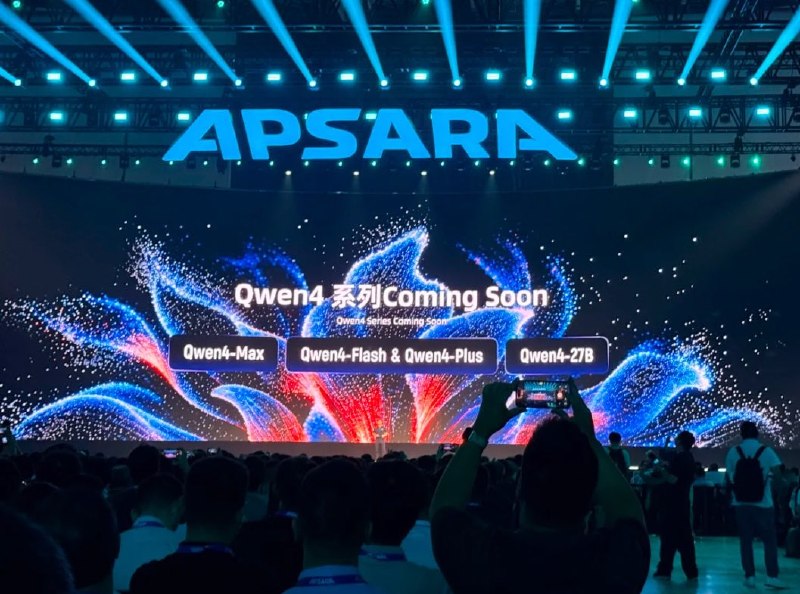
Alibaba a annoncé le lancement imminent de la gamme de modèles d'IA Qwen4, accompagnée de la nouvelle puce Zhenwu V900, revendiquant une puissance trois fois supérieure à celle de sa génération précédente.
Lors de l'ouverture de la Cloud Intelligence Conference 2026, Liu Daiheng, nouveau responsable de la direction des grands modèles de langage (LLM) chez Qwen, a officiellement annoncé la future famille de modèles Qwen4.
Cette gamme comprendra les variantes suivantes :
- Qwen4-Max
- Qwen4-Flash
- Qwen4-Plus
- Qwen4-27B
À l'avenir, Qwen prévoit d'évoluer vers l'entraînement de modèles atteignant une échelle de 5 à 10 billions de paramètres.
En parallèle, Alibaba a présenté la puce IA Zhenwu V900, qui, selon l'entreprise, offre une puissance de calcul trois fois supérieure à celle de la génération précédente. Sur la base de cette puce, Alibaba envisage de construire des clusters regroupant jusqu'à 500 000 accélérateurs. D'ici 2032, la capacité des centres de données d'Alibaba devrait atteindre 20 GW.
Pourquoi c'est important
AnalyseL'annonce conjointe de Qwen4 et de la puce Zhenwu V900 confirme les ambitions stratégiques d'Alibaba dans le domaine des grands modèles de langage et son engagement envers une infrastructure d'IA propriétaire.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Modèles de pointe (Frontier Models)
La classe d'intelligence artificielle la plus puissante à l'avant-garde de la recherche mondiale (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), définissant les limites actuelles des capacités de raisonnement, d'autonomie et de codage.
Alibaba Qwen (Leader in Open-Source Coding and Mathematics)
A series of high-performance open-source models from Alibaba's cloud division (Qwen 2.5, Qwen Coder). Recognized as a leader among open models for code generation, mathematics, and multilingual text processing.
Thinking Machines lance Inkling 2 Small : un modèle MoE de 594B capable d’affiner d’autres modèles
Thinking Machines a présenté Inkling 2 Small, un modèle MoE de 594B paramètres qui domine parmi les modèles ouverts sur plusieurs tâches et a démontré la capacité d’affiner Qwen3.5-4B de manière autonome.
Thinking Machines présente Inkling 2 Small : un modèle MoE qui rivalise avec des flagships plus grands
Thinking Machines a présenté Inkling 2 Small, un modèle multimodal basé sur une architecture Mixture-of-Experts avec 594 milliards de paramètres et 17 milliards actifs par token. Les poids complets doivent être publiés la semaine prochaine sous licence Apache 2.0.