Alibaba anuncia oficialmente la familia de modelos Qwen4
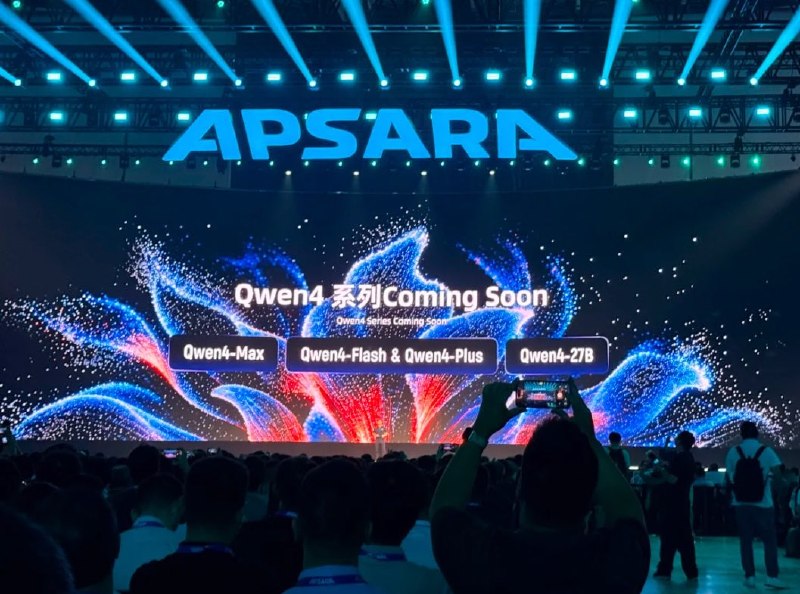
Alibaba ha anunciado la próxima familia de modelos de IA Qwen4 y ha presentado el chip Zhenwu V900, que según la empresa es tres veces más potente que su predecesor.
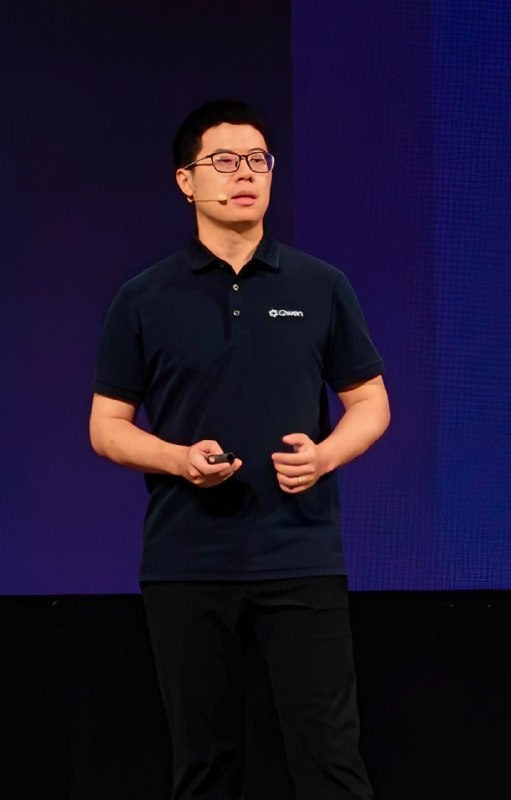
En la apertura de la Cloud Intelligence Conference 2026, el nuevo director de la dirección LLM en Qwen, Liu Daiheng, anunció la próxima familia de modelos Qwen4.
Esta incluirá:
- Qwen4-Max
- Qwen4-Flash
- Qwen4-Plus
- Qwen4-27B
En el futuro, Qwen pretende pasar al entrenamiento de modelos con una escala de 5–10 billones de parámetros.
Paralelamente, Alibaba presentó el chip de IA Zhenwu V900, que, según la compañía, es tres veces más potente que la generación anterior. Sobre su base planean construir clústeres de hasta 500.000 aceleradores, y para 2032 la potencia de los centros de datos de Alibaba debería crecer hasta los 20 GW.
Por qué es importante
AnálisisEl anuncio de Qwen4 y del nuevo chip confirma los ambiciosos planes de Alibaba en el campo de los grandes modelos de lenguaje y su propia infraestructura de IA.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Modelos Frontera
La clase más poderosa de inteligencia artificial en la vanguardia de la investigación mundial (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), que define los límites de las capacidades modernas de razonamiento, autonomía y codificación.
Alibaba Qwen (Líder en Código Abierto y Matemáticas)
Serie de modelos de alto rendimiento de la división en la nube de Alibaba (Qwen 2.5, Qwen Coder). Reconocido líder entre los modelos abiertos en programación, matemáticas y procesamiento de texto multilingüe.
Thinking Machines lanza Inkling 2 Small: un modelo MoE de 594B que puede afinar otros modelos
Thinking Machines presentó Inkling 2 Small, un modelo MoE de 594B parámetros con 17B activos que lidera entre modelos abiertos en varias tareas y demostró poder fine-tunear Qwen3.5-4B de forma autónoma.
Revolut traslada a unos 2.000 ingenieros a modelos GLM locales para programación
Revolut movió a unos 2.000 ingenieros a modelos GLM desplegados localmente, reduciendo el coste de IA para programar en unas diez veces y el tiempo de ejecución de tareas en un 70%.