Revolut traslada a unos 2.000 ingenieros a modelos GLM locales para programación
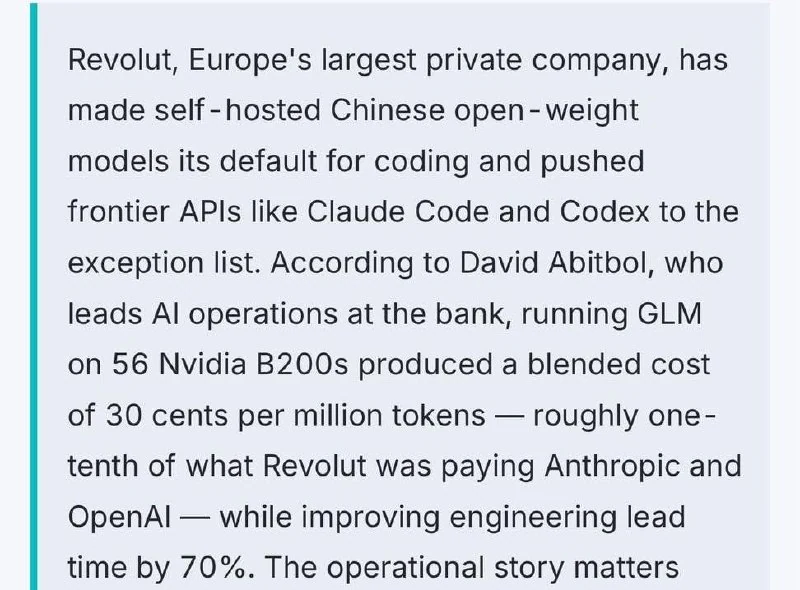
Revolut movió a unos 2.000 ingenieros a modelos GLM desplegados localmente, reduciendo el coste de IA para programar en unas diez veces y el tiempo de ejecución de tareas en un 70%.
Revolut ha trasladado a unos 2.000 ingenieros a modelos GLM desplegados localmente para programación, mientras que Claude Code y Codex ahora se usan solo en casos excepcionales.
Según David Abitbol, responsable de operaciones de IA en la compañía, el despliegue utiliza 56 aceleradores Nvidia B200. El coste medio fue de apenas 30 céntimos por millón de tokens, aproximadamente diez veces menos de lo que Revolut pagaba a Anthropic y OpenAI.
Al mismo tiempo, el tiempo de ejecución de tareas de ingeniería se redujo un 70%.
El detalle más interesante es que las mejoras se hicieron visibles cuando los ingenieros dejaron de ahorrar tokens. Dejaron de usar la IA solo para tareas complejas y empezaron a usarla casi en todas partes.
Los modelos propietarios avanzados se están convirtiendo en la excepción, mientras que los modelos de pesos abiertos pasan a ser la herramienta principal. Para cada empresa de IA que se prepara para salir a bolsa, esto supone un grave problema de precios.
Por qué es importante
AnálisisEl caso muestra que los modelos locales de pesos abiertos pueden convertirse en el estándar de trabajo para equipos de ingeniería, no solo en una alternativa barata. Esto presiona los modelos de precios de los proveedores de IA propietarios y sus salidas a bolsa.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Modelos Frontera
La clase más poderosa de inteligencia artificial en la vanguardia de la investigación mundial (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), que define los límites de las capacidades modernas de razonamiento, autonomía y codificación.
Mistral AI (Modelos Abiertos y Eficientes de Europa)
Serie de modelos abiertos y comerciales de alto rendimiento del startup francés Mistral AI (Mistral 7B, Mixtral 8x7B, Mistral Large). Conocidos por su compacidad, velocidad y respeto por la privacidad de los datos.
Investigadores del MIT muestran que un LLM puede leer y editar pesos de modelos sin entrenamiento
El equipo de MIT CSAIL presentó Weight-Space Programming: Astra leyó y modificó los pesos de Qwen3.5-0.8B sin descenso de gradiente ni fine-tuning, mejorando sus resultados en benchmarks matemáticos.
Cuando Claude Code pide permiso para ejecutar un comando justo mientras te duchas
Una observación ligera sobre cómo las herramientas de código con IA pueden interrumpir al desarrollador en el peor momento.