Thinking Machines lança Inkling 2 Small: modelo MoE que compete com flagships maiores
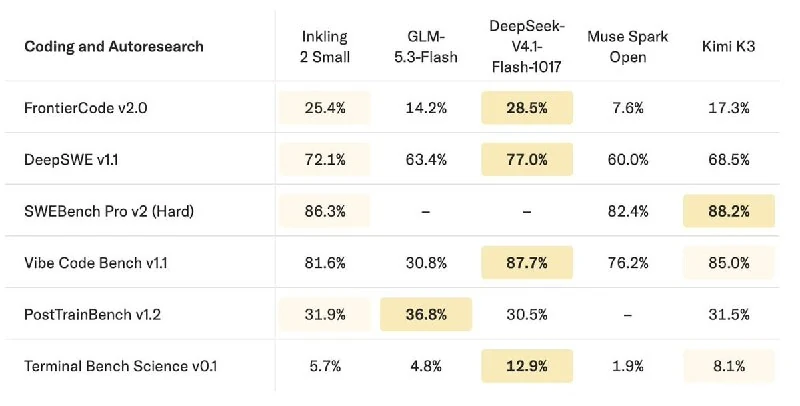
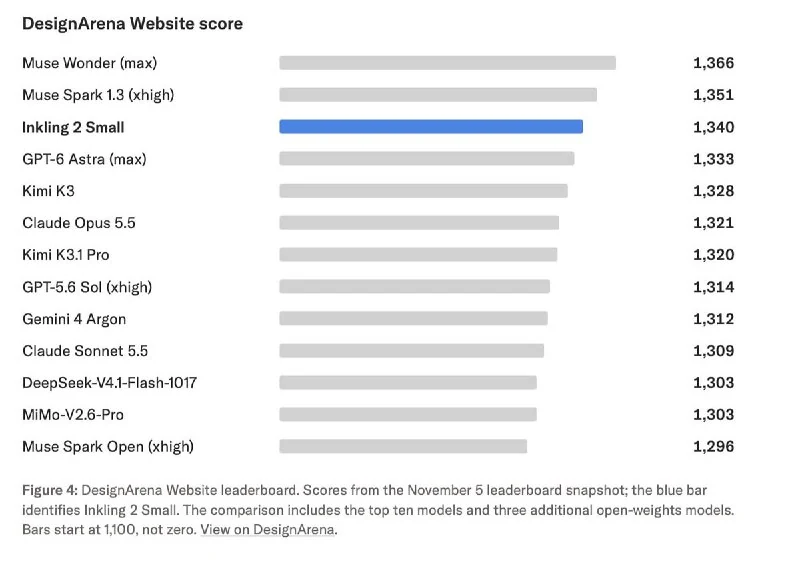
A Thinking Machines lançou o Inkling 2 Small, um modelo que, apesar do tamanho, consegue competir com flagships muito maiores.
Ele foi construído sobre uma arquitetura Mixture-of-Experts e possui 594 bilhões de parâmetros, mas ativa apenas 17 bilhões ao processar cada token. Além disso, o modelo pode trabalhar com imagens e permite ajustar a profundidade do raciocínio.
Em testes de programação, o Inkling 2 Small não fica atrás de muitos modelos consideravelmente maiores. O resultado mais interessante é o terceiro lugar no DesignArena, onde ficou logo atrás dos modelos fechados mais potentes.
Os pesos completos devem ser publicados já na próxima semana sob licença Apache 2.0.
Por que isso importa
AnáliseO modelo mostra que a arquitetura Mixture-of-Experts pode entregar desempenho de flagship com menos computação por token. Pesos sob Apache 2.0 podem acelerar experimentos e implantações.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Thinking Machines lança Inkling 2 Small: modelo MoE de 594B que pode treinar outros modelos
A Thinking Machines apresentou o Inkling 2 Small, um modelo MoE de 594B parâmetros que lidera entre modelos abertos em várias tarefas e demonstrou poder fazer fine-tuning do Qwen3.5-4B de forma autônoma.
Parte II. Arquitetura de Agentes de IA: do Modelo à Memória e Ferramentas
Imersão profunda em engenharia: tokenização, cache KV, determinismo de amostragem, stack de treinamento, quantização, engenharia de contexto, stack de segurança, RAG em produção, ReAct e sistemas swarm multiagente.
Modelos de Fronteira
A classe mais poderosa de inteligência artificial na vanguarda da pesquisa global (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), que define os limites atuais das capacidades de raciocínio, autonomia e codificação.
LLM (Large Language Model - Modelo de Linguagem Grande)
Classe fundamental de arquiteturas de redes neurais baseada em transformadores autorregressivos, que prevê a distribuição probabilística dos próximos tokens e demonstra propriedades emergentes de pensamento abstrato, síntese de código e raciocínio lógico.