Thinking Machines представила Inkling 2 Small: MoE-модель, яка конкурує з більшими флагманами
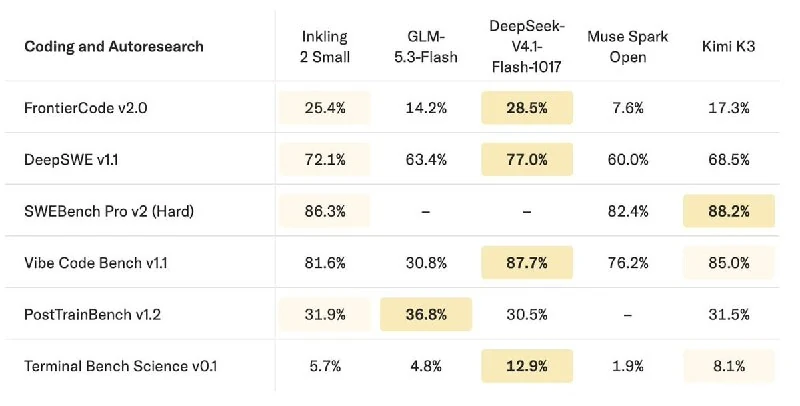
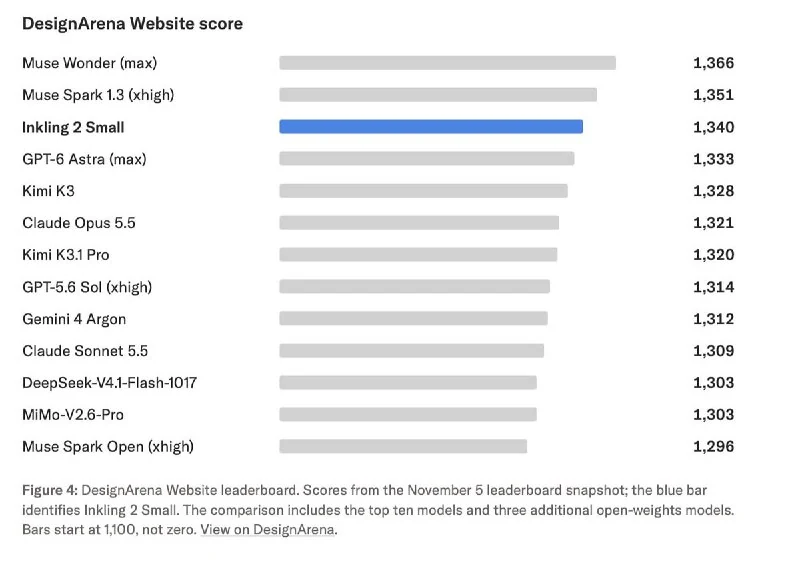
Thinking Machines представила Inkling 2 Small — модель, яка, попри свої розміри, здатна конкурувати з набагато більшими флагманами.
Вона побудована на архітектурі Mixture-of-Experts і має 594 млрд параметрів, але під час обробки кожного токена залучає лише 17 млрд. Крім того, модель працює з зображеннями та дозволяє регулювати глибину міркувань.
У тестах із програмування Inkling 2 Small не поступається багатьом значно більшим моделям. Найбільш показовим є третє місце в DesignArena, де модель опинилася одразу за найпотужнішими закритими моделями.
Повні ваги обіцяють опублікувати вже наступного тижня під ліцензією Apache 2.0.
Чому це важливо
АналітикаПоказує, що архітектура Mixture-of-Experts дозволяє отримати флагманську якість при менших обчислювальних витратах. Відкриті ваги під Apache 2.0 можуть прискорити експерименти та впровадження ШІ в проєктах.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Thinking Machines випустила модель Inkling 2 Small: MoE на 594B параметрів і автономне дообучання інших моделей
Thinking Machines представила Inkling 2 Small — велику MoE-модель, яка вже лідирує серед відкритих моделей у низці задач і вміє самостійно дообучати інші моделі.
OpenAI представила GPT-6 Cyber — модель для кібербезпеки з новими рекордами
За опублікованими результатами, GPT-6 Cyber встановила нові рекорди в кібербезпеці, включаючи бенчмарк ExploitGym та виявлення вразливостей Firefox, але доступ залишається обмеженим.
LLM (Large Language Model - Велика мовна модель)
Фундаментальний клас нейромережевих архітектур на базі авторегресійного трансформера, що передбачає ймовірнісний розподіл наступних токенів і демонструє емерджентні властивості абстрактного мислення, синтезу коду та логічного висновку.
Частина I. Архітектура ШІ-агентів: фундаментальні блоки
Десять фундаментальних блоків сучасного агента: таксономія моделей, рантайм-петля, техніки промптингу, дистиляція, навички (skills), пам'ять, function calling та юніт-економіка.