Xiaomi выпустила MiMo-V2.6: новая открытая модель ИИ, обошедшая конкурентов
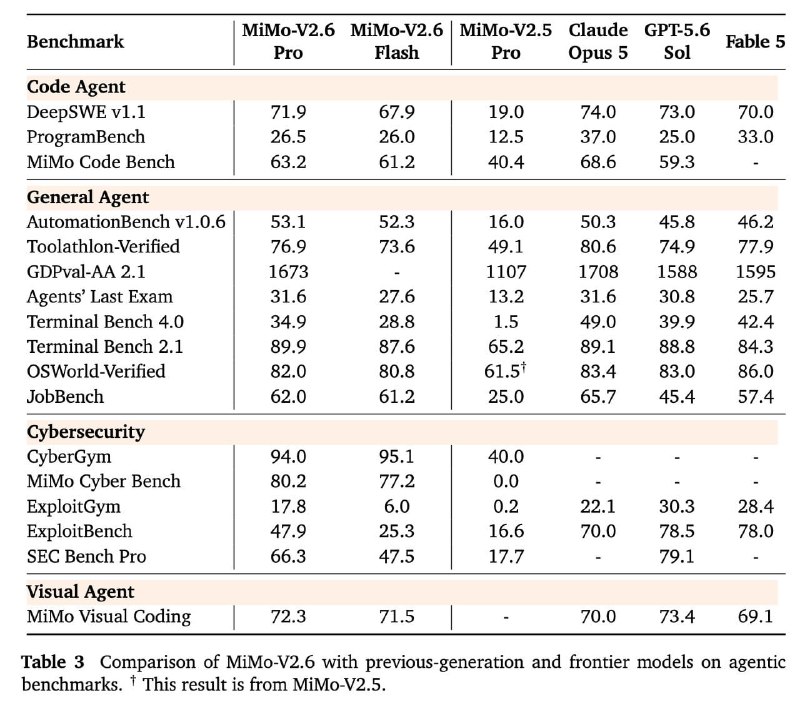
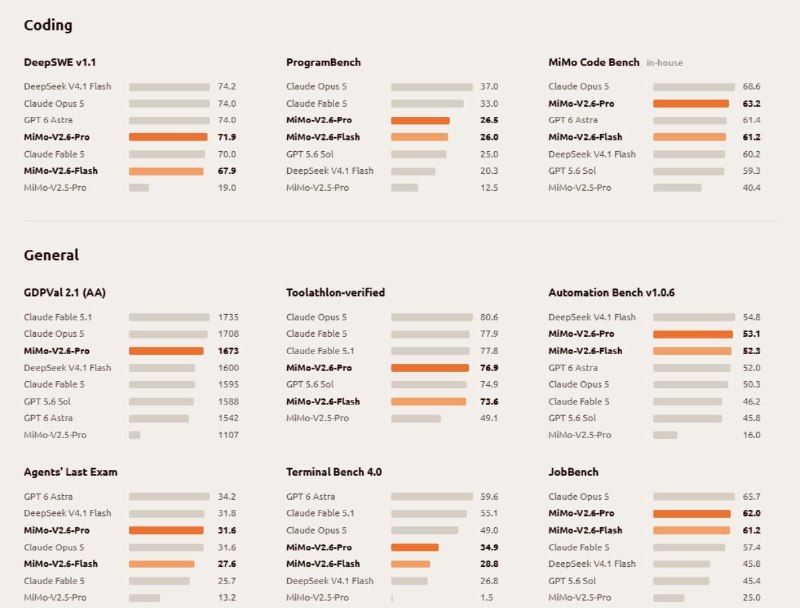
Xiaomi представила новые открытые модели ИИ MiMo-V2.6 Pro и Flash, которые возглавили рейтинг среди открытых решений, предложив высокую производительность по значительно более низкой цене по сравнению с международными конкурентами.
Xiaomi снова в игре: выпуск MiMo-V2.6
Китайская компания Xiaomi ночью выпустила новые модели искусственного интеллекта MiMo-V2.6 Pro и Flash, показав очень сильные результаты.
Xiaomi потратила 130 часов, 75 млрд токенов и $2,6 млн на обучение с подкреплением (RL), чтобы вывести MiMo-V2.6 Pro на первое место среди открытых моделей. И у них получилось.
Производительность и цена
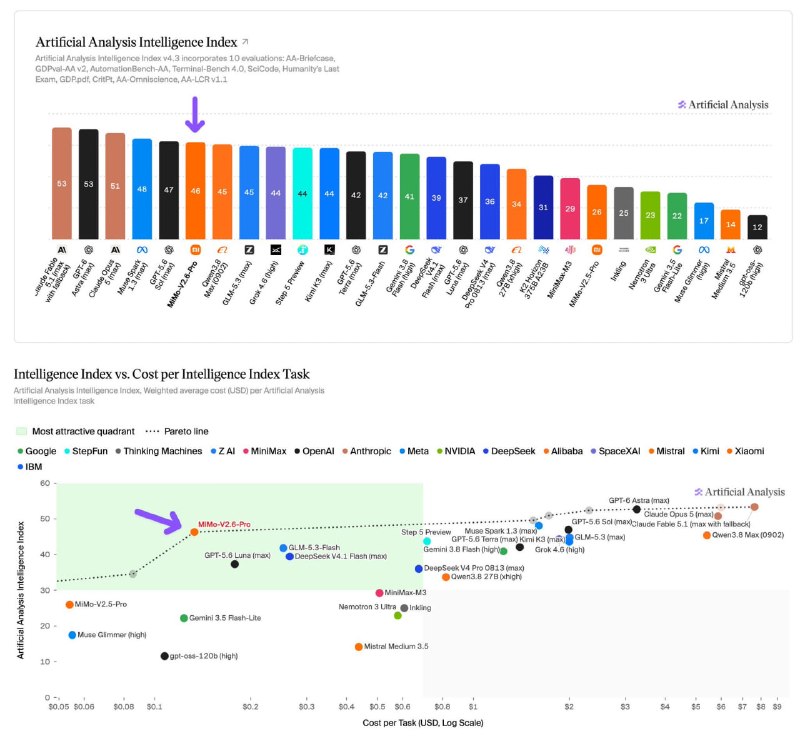
Индекс AA Intelligence составил 46,32, что выше показателей Kimi K3 и Qwen3.8 Max. При этом цена осталась такой же, как у версии V2.5.
При сопоставимом уровне интеллекта стоимость запросов составляет всего 1/20–1/60 от международных флагманов:
- MiMo-V2.6 Pro: $0.435 / $0.87
- MiMo-V2.6 Flash: $0.14 / $0.28 (примерно треть цены Pro)
- DeepSeek V4 Pro: около $0.66–1.32 / $1.98–3.96 (Pro дешевле примерно в 2–5 раз)
- GLM-5.3: около $1.40 / $4.40 (Pro дешевле примерно в 3–5 раз)
- Qwen3.8 Max: около $2 / $6 (Pro дешевле примерно в 5–7 раз)
- Gemini 3.5 Flash: около $1.50 / $9 (Pro дешевле примерно в 3–10 раз)
- Gemini 3.1 Pro: около $2 / $12 (Pro дешевле примерно в 5–14 раз)
- GPT-5.6 Sol: около $4–5 / $20 (Pro дешевле примерно в 10–23 раза)
- Claude Opus 5: около $5 / $25 (Pro дешевле примерно в 12–29 раз)
- Claude Fable 5: около $10 / $50 (Pro дешевле примерно в 23–58 раз)
Одна задача обходится примерно в $0.13.
Прозрачность разработки
Весь процесс обучения транслировался в реальном времени, а расходы и сбои публиковались онлайн. Вместе с моделью открыты веса, код RL и среды. Официальная страница: mimo.xiaomi.com.
Почему это важно
АналитикаРелиз MiMo-V2.6 меняет расстановку сил в сегменте открытых моделей ИИ, предлагая производительность уровня топовых закрытых решений по экстремально низкой цене, что делает продвинутый ИИ доступным для малого бизнеса и разработчиков.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Thinking Machines выпустила новую модель Inkling 2 Small
Thinking Machines представила Inkling 2 Small — MoE-модель на 594B параметров, которая заняла первое место среди открытых моделей в общем лидерборде и умеет самостоятельно дообучать другие модели.
Thinking Machines выпустила Inkling 2 Small: MoE-модель, которая конкурирует с более крупными флагманами
Thinking Machines выпустила Inkling 2 Small — мультимодальную модель на архитектуре Mixture-of-Experts, которая по результатам тестов конкурирует с более крупными флагманами. Полные веса обещают опубликовать на следующей неделе под лицензией Apache 2.0.
LLM (Large Language Model - Большая языковая модель)
Фундаментальный класс нейросетевых архитектур на основе авторегрессионного трансформера, который предполагает вероятностное распределение следующих токенов и демонстрирует эмергентные свойства абстрактного мышления, синтеза кода и логического вывода.
Часть I. Архитектура ИИ-агентов: фундаментальные блоки
Одиннадцать фундаментальных строительных блоков современного ИИ-агента: таксономия моделей, агентный рантайм, техники промптинга, дистилляция, архитектура навыков (skills), память, function calling и FinOps.