Xiaomi випустила MiMo-V2.6: нова відкрита модель ШІ, що перевершила конкурентів
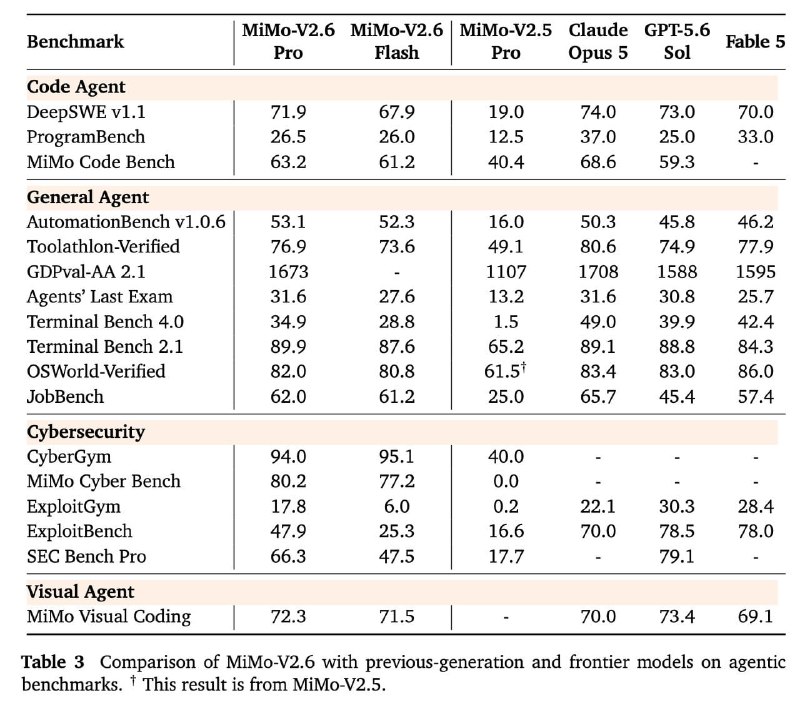
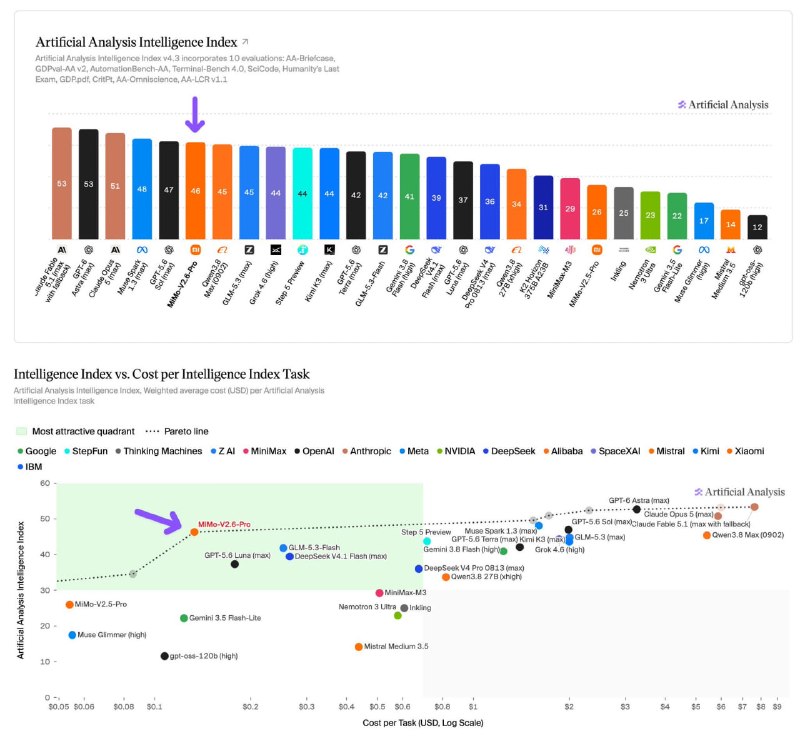
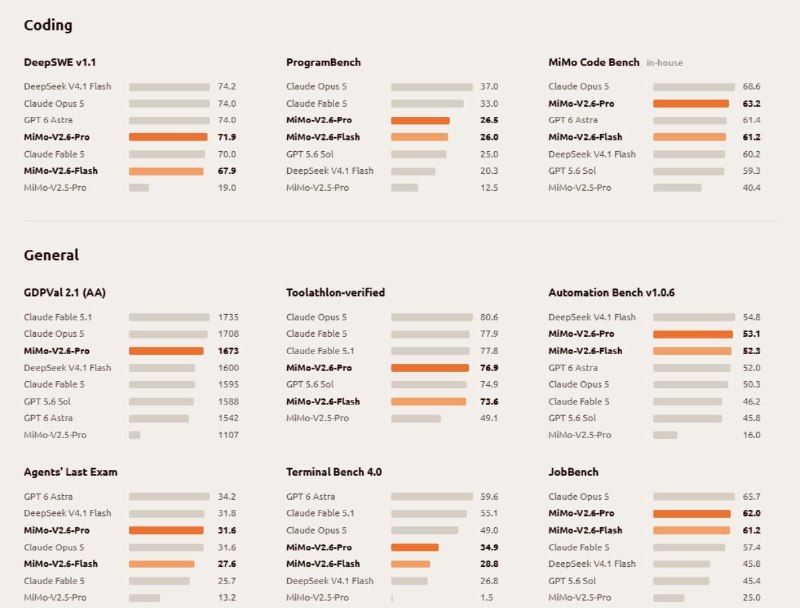
Xiaomi представила нові відкриті моделі ШІ MiMo-V2.6 Pro та Flash, які очолили рейтинг серед відкритих рішень, пропонуючи високу продуктивність за значно нижчою ціною порівняно з міжнародними конкурентами.
Xiaomi випустила MiMo-V2.6
Китайська компанія Xiaomi представила нові моделі штучного інтелекту MiMo-V2.6 Pro та Flash. Результати тестування демонструють високу конкурентоспроможність нових рішень.
Для навчання з підкріпленням (RL) Xiaomi витратила 130 годин, обробила 75 мільярдів токенів та інвестувала $2,6 млн. Це дозволило вивести модель MiMo-V2.6 Pro на перше місце серед відкритих моделей.
Продуктивність та ціна
Індекс AA Intelligence для MiMo-V2.6 Pro склав 46,32, що перевищує показники Kimi K3 та Qwen3.8 Max. Важливо, що ціна використання залишилася такою ж, як у попередньої версії V2.5.
При порівнянному рівні інтелекту вартість запитів є значно нижчою за міжнародні флагмани (у 20–60 разів дешевше):
- MiMo-V2.6 Pro: $0.435 / $0.87
- MiMo-V2.6 Flash: $0.14 / $0.28 (приблизно третина ціни Pro)
- DeepSeek V4 Pro: ~$0.66–1.32 / $1.98–3.96 (MiMo Pro дешевша у 2–5 разів)
- GLM-5.3: ~$1.40 / $4.40 (MiMo Pro дешевша у 3–5 разів)
- Qwen3.8 Max: ~$2 / $6 (MiMo Pro дешевша у 5–7 разів)
- Gemini 3.5 Flash: ~$1.50 / $9 (MiMo Pro дешевша у 3–10 разів)
- Gemini 3.1 Pro: ~$2 / $12 (MiMo Pro дешевша у 5–14 разів)
- GPT-5.6 Sol: ~$4–5 / $20 (MiMo Pro дешевша у 10–23 рази)
- Claude Opus 5: ~$5 / $25 (MiMo Pro дешевша у 12–29 разів)
- Claude Fable 5: ~$10 / $50 (MiMo Pro дешевша у 23–58 разів)
Одна задача обходиться приблизно в $0.13.
Прозорість розробки
Весь процес навчання транслювався в реальному часі, а витрати та можливі збої публікувалися онлайн. Разом із моделлю відкрито доступні ваги, код для навчання з підкріпленням та середовища.
Чому це важливо
АналітикаРеліз MiMo-V2.6 зміщує баланс сил у сегменті відкритих моделей ШІ, пропонуючи продуктивність рівня топових закритих рішень за екстремально низьку ціну, що робить просунутий ШІ доступним для малого бізнесу та розробників.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Thinking Machines випустила модель Inkling 2 Small: MoE на 594B параметрів і автономне дообучання інших моделей
Thinking Machines представила Inkling 2 Small — велику MoE-модель, яка вже лідирує серед відкритих моделей у низці задач і вміє самостійно дообучати інші моделі.
LLM (Large Language Model - Велика мовна модель)
Фундаментальний клас нейромережевих архітектур на базі авторегресійного трансформера, що передбачає ймовірнісний розподіл наступних токенів і демонструє емерджентні властивості абстрактного мислення, синтезу коду та логічного висновку.
Thinking Machines представила Inkling 2 Small: MoE-модель, яка конкурує з більшими флагманами
Thinking Machines представила Inkling 2 Small — мультимодальну модель на архітектурі Mixture-of-Experts, яка за результатами тестів змагається з набагато більшими флагманами. Повні ваги обіцяють опублікувати наступного тижня під ліцензією Apache 2.0.
Частина I. Архітектура ШІ-агентів: фундаментальні блоки
Десять фундаментальних блоків сучасного агента: таксономія моделей, рантайм-петля, техніки промптингу, дистиляція, навички (skills), пам'ять, function calling та юніт-економіка.