Thinking Machines stellt Inkling 2 Small vor: MoE-Modell konkurriert mit größeren Flaggschiffen
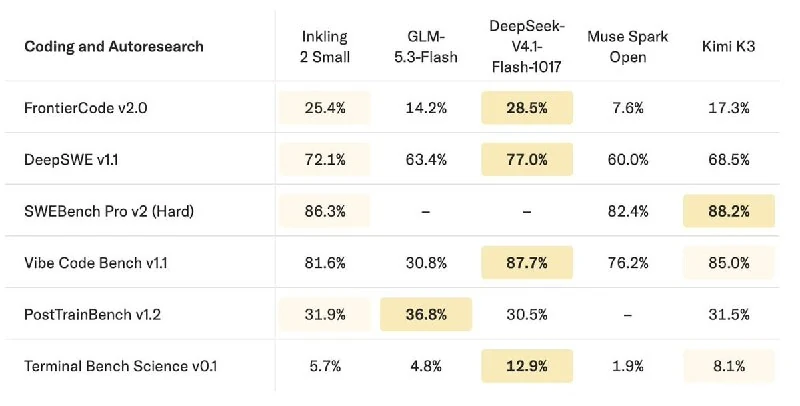
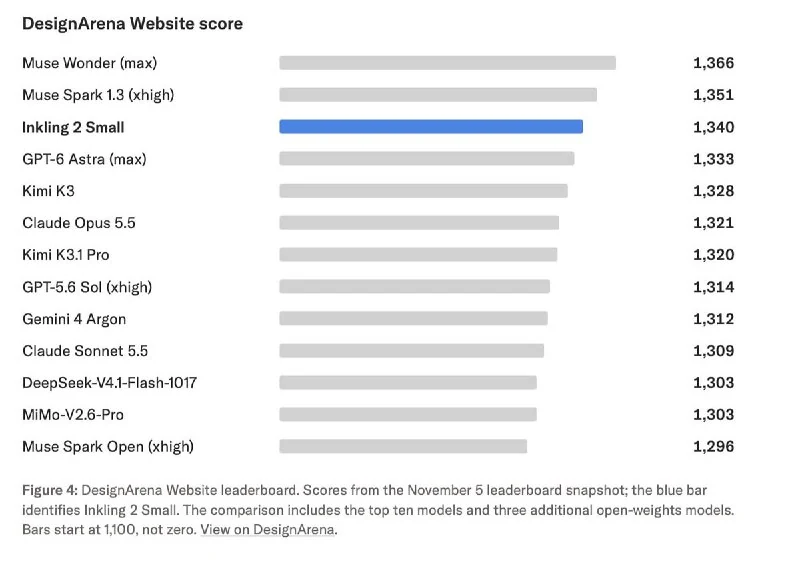
Thinking Machines hat Inkling 2 Small vorgestellt — ein multimodales Mixture-of-Experts-Modell mit 594 Milliarden Parametern und 17 Milliarden aktiven Parametern pro Token. Die vollständigen Gewichte sollen nächste Woche unter Apache 2.0 veröffentlicht werden.
Thinking Machines hat Inkling 2 Small veröffentlicht – ein Modell, das trotz seiner Größe mit deutlich größeren Flaggschiffen konkurrieren kann.
Es basiert auf einer Mixture-of-Experts-Architektur und umfasst 594 Milliarden Parameter, aktiviert bei der Verarbeitung eines Tokens jedoch nur 17 Milliarden. Zusätzlich kann das Modell mit Bildern arbeiten und erlaubt eine Anpassung der Tiefe der Schlussfolgerungen.
In Programmierbenchmarks steht Inkling 2 Small vielen deutlich größeren Modellen in nichts nach. Besonders auffällig ist der dritte Platz in DesignArena, wo es direkt hinter den leistungsstärksten geschlossenen Modellen landete.
Die vollständigen Gewichte sollen bereits nächste Woche unter der Apache-2.0-Lizenz veröffentlicht werden.
Warum das wichtig ist
AnalyseDas Modell zeigt, dass Mixture-of-Experts Flaggschiff-Leistung mit geringerem Rechenbedarf pro Token liefern kann. Apache-2.0-Gewichte könnten Experimente und den Einsatz beschleunigen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Thinking Machines veröffentlicht Inkling 2 Small: ein 594B-MoE-Modell, das andere Modelle feinabstimmen kann
Thinking Machines hat Inkling 2 Small vorgestellt, ein MoE-Modell mit 594B Parametern, das unter offenen Modellen in mehreren Benchmarks führt und autonom Qwen3.5-4B feinabstimmen konnte.
OpenAI stellt GPT-6 Cyber vor – Modell mit neuen Rekorden für Cybersicherheit
OpenAI berichtet über neue Cybersicherheits-Ergebnisse von GPT-6 Cyber, darunter 48,5 % im ExploitGym-Benchmark und 81 zuvor unbekannte Firefox-Schwachstellen; der Zugang bleibt zunächst beschränkt.
Teil II. Architektur von KI-Agenten: Vom Modell zu Gedächtnis und Tools
Tiefes technisches Eintauchen: Tokenisierung, KV-Cache, Determinismus beim Sampling, Trainings-Stack, Quantisierung, Kontext-Engineering, Security-Stack, produktives RAG, ReAct sowie Multi-Agenten-Swarm-Systeme.
Frontier-Modelle
Die leistungsstärkste Klasse künstlicher Intelligenz an der Spitze der globalen Forschung (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), die die Grenzen moderner Fähigkeiten in Bezug auf Reasoning, Autonomie und Coding definiert.