Thinking Machines wypuściła Inkling 2 Small: model MoE, który konkuruje z większymi flagowcami
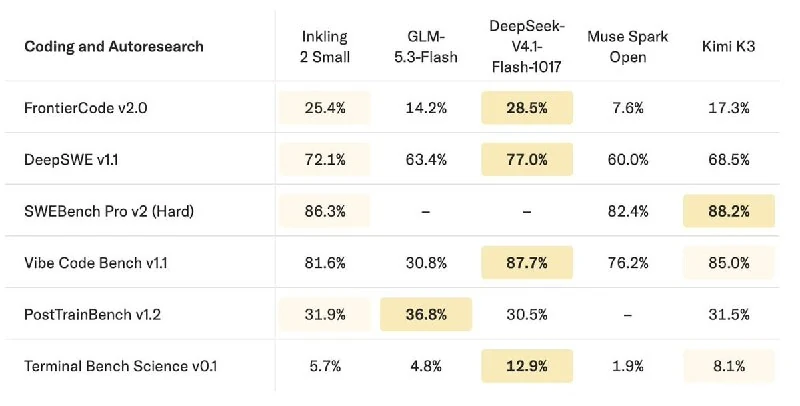
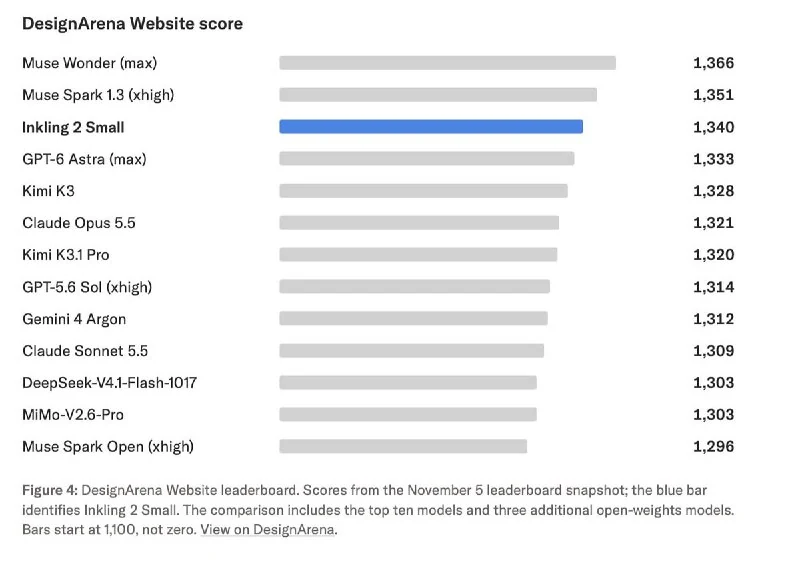
Thinking Machines zaprezentowało Inkling 2 Small — multimodalny model oparty na architekturze Mixture-of-Experts z 594 miliardami parametrów i 17 miliardami aktywowanymi na token. Pełne wagi mają zostać opublikowane w przyszłym tygodniu na licencji Apache 2.0.
Thinking Machines wypuściło Inkling 2 Small — model, który mimo swoich rozmiarów potrafi konkurować z znacznie większymi flagowcami.
Został zbudowany na architekturze Mixture-of-Experts i ma 594 miliardy parametrów, ale podczas przetwarzania każdego tokenu aktywuje tylko 17 miliardów. Dodatkowo model potrafi pracować z obrazami i pozwala regulować głębokość rozumowania.
W testach programowania Inkling 2 Small nie ustępuje wielu znacznie większym modelom. Najbardziej interesujący jest trzeci miejsce w DesignArena, gdzie uplasował się tuż za najmocniejszymi zamkniętymi modelami.
Pełne wagi mają zostać opublikowane już w przyszłym tygodniu na licencji Apache 2.0.
Dlaczego to ważne
AnalizaModel pokazuje, że architektura Mixture-of-Experts może zapewniać poziom flagowców przy mniejszych kosztach obliczeniowych na token. Wagi Apache 2.0 mogą przyspieszyć eksperymenty i wdrożenia.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Thinking Machines wypuszcza Inkling 2 Small: model MoE 594B, który potrafi dostrajać inne modele
Thinking Machines zaprezentowało Inkling 2 Small — model MoE o 594B parametrów, który prowadzi wśród modeli otwartych w wielu zadaniach i samodzielnie dostrajał Qwen3.5-4B.
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.
Modele Frontier
Najsilniejsza klasa sztucznej inteligencji na czele światowych badań (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), wyznaczająca granice współczesnych możliwości w zakresie rozumowania, autonomii i programowania.
LLM (Large Language Model - Duży Model Językowy)
Fundamentalna klasa architektur sieci neuronowych opartych na autoregresyjnym transformatorze, która przewiduje rozkład prawdopodobieństwa kolejnych tokenów i wykazuje emergentne właściwości abstrakcyjnego myślenia, syntezy kodu oraz wnioskowania logicznego.