Premiera dnia: MiMo-2.6 od Xiaomi – nowy otwarty model SOTA
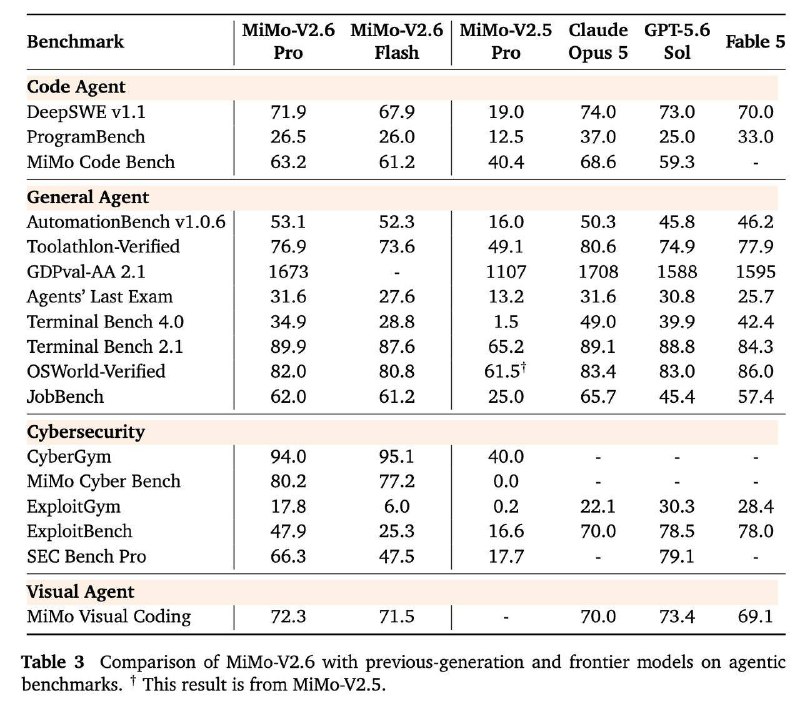
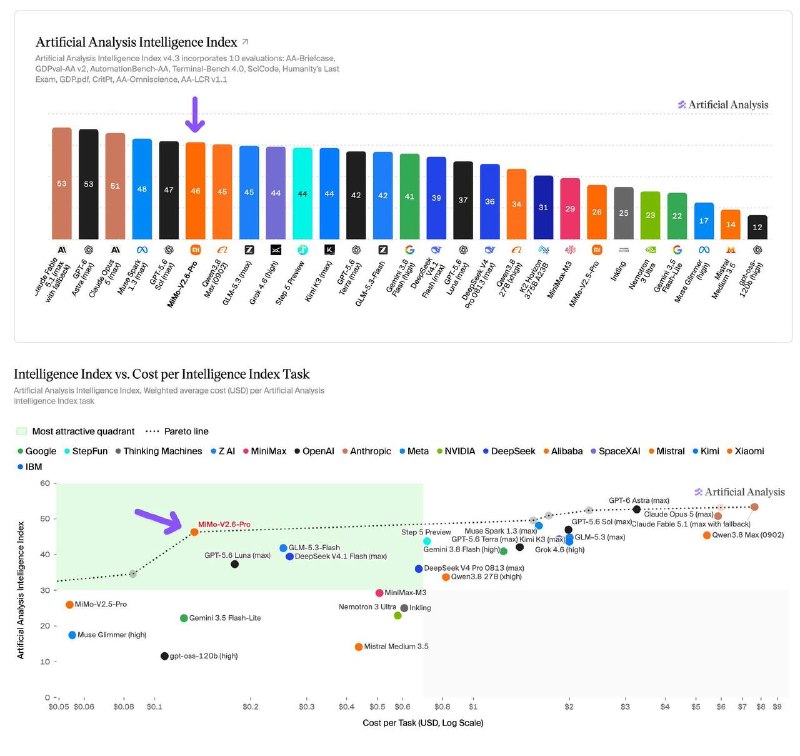
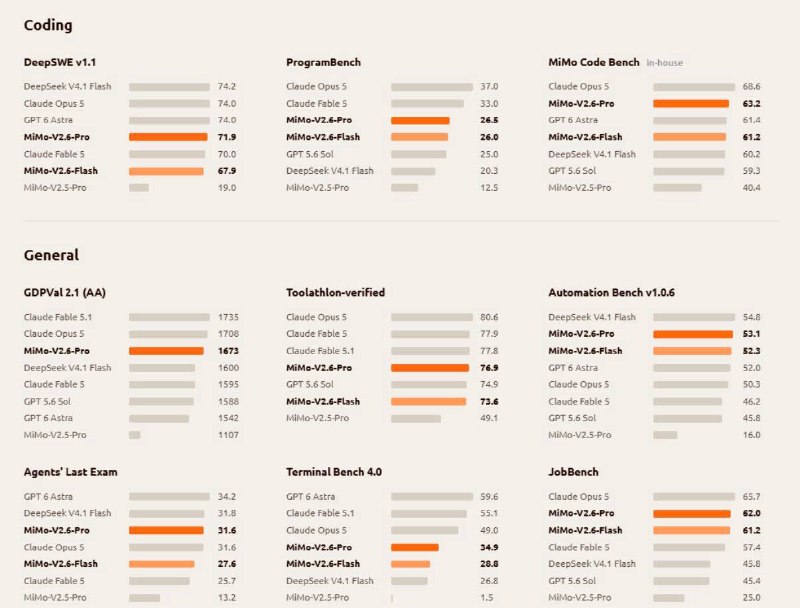
Xiaomi udostępniło MiMo-2.6, otwarty model multimodalny z kontekstem 1 mln tokenów, który konkuruje z zamkniętymi rozwiązaniami przy znacznie niższych kosztach.
Firma Xiaomi niedawno wypuściła model MiMo-2.6, który wydaje się być nowym state-of-the-art (SOTA) modelem open-source. Według deweloperów wersja Pro osiąga wyniki porównywalne z Claude Opus 5 oraz GPT-5.6 Sol w większości benchmarków agentowych (zdobywając 46 punktów w Artificial Analysis Intelligence Index).
Architektonicznie jest to model MoE (Mixture of Experts) z 1,02 miliarda parametrów (42 miliardy aktywne), wyposażony w hybrydową uwagę i spekulacyjny dekoder MTP składający się z 5 warstw. Pozwala to modelowi przewidywać wiele tokenów do przodu i równolegle weryfikować ich poprawność, co zapewnia znaczący wzrost prędkości.
Kluczowe cechy:
- Kontekst: Do 1 miliona tokenów.
- Multimodalność: Natywne wsparcie.
- Skala RL: 750 000 trajektorii uczenia ze wzmocnieniem dla zadań kodowania, wizji i CFT.
- Asynchroniczny GRPO: Model próbuje 16 różnych ścieżek rozwiązania dla każdego zadania równolegle.
- Infrastruktura: Ponad 7000 środowisk agenta RL również zostało udostępnionych na zasadzie open-source.
Koszt szkolenia wyniósł jedynie 3 miliony dolarów dzięki wykorzystaniu weryfikowalnych zadań bez konieczności etykietowania danych.
Cennik API:
- Pro: $0,435 / M input, $0,87 / M output
- Flash: $0,14 / M input, $0,28 / M output
Dlaczego to ważne
AnalizaPremiera MiMo-2.6 wzmacnia trend dostępności modeli AI najwyższej klasy poprzez open source, obniżając bariery wejścia dla twórców agentów dzięki niskim kosztom wnioskowania i szkolenia.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.
Modele Frontier
Najsilniejsza klasa sztucznej inteligencji na czele światowych badań (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), wyznaczająca granice współczesnych możliwości w zakresie rozumowania, autonomii i programowania.
LLM (Large Language Model - Duży Model Językowy)
Fundamentalna klasa architektur sieci neuronowych opartych na autoregresyjnym transformatorze, która przewiduje rozkład prawdopodobieństwa kolejnych tokenów i wykazuje emergentne właściwości abstrakcyjnego myślenia, syntezy kodu oraz wnioskowania logicznego.
Thinking Machines wypuszcza Inkling 2 Small: model MoE 594B, który potrafi dostrajać inne modele
Thinking Machines zaprezentowało Inkling 2 Small — model MoE o 594B parametrów, który prowadzi wśród modeli otwartych w wielu zadaniach i samodzielnie dostrajał Qwen3.5-4B.