Релиз дня: MiMo-2.6 от Xiaomi — новая открытая SOTA-модель
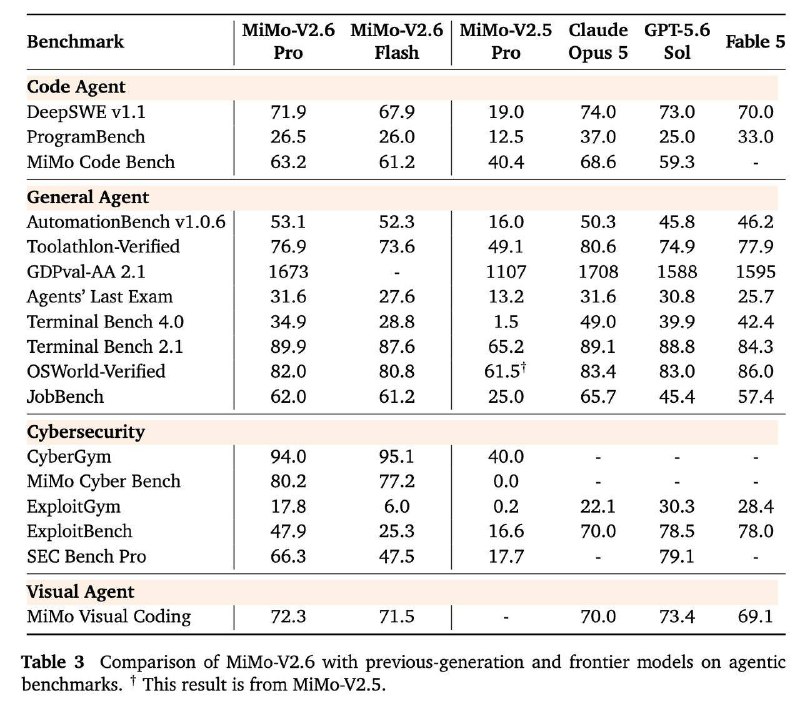
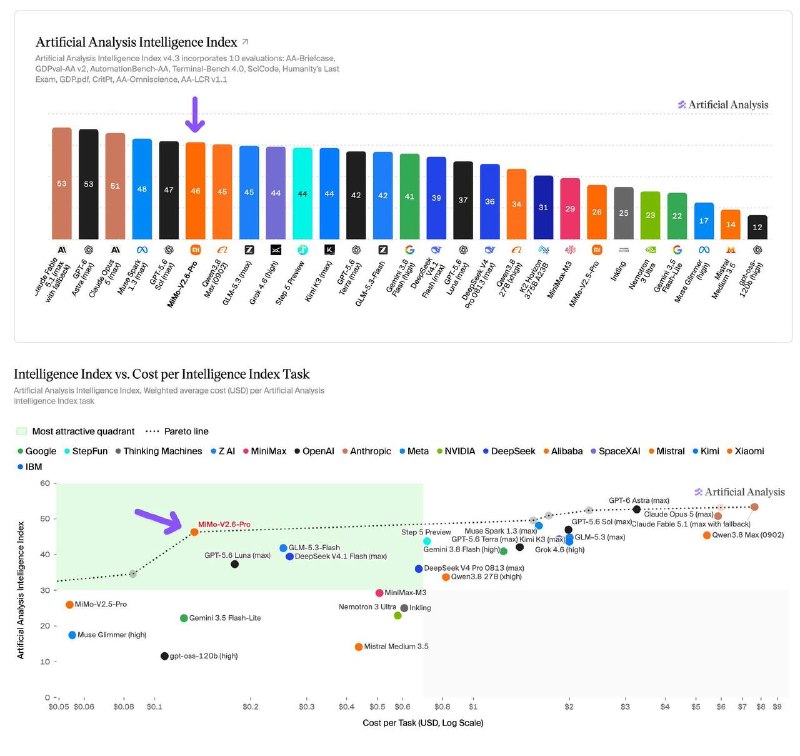
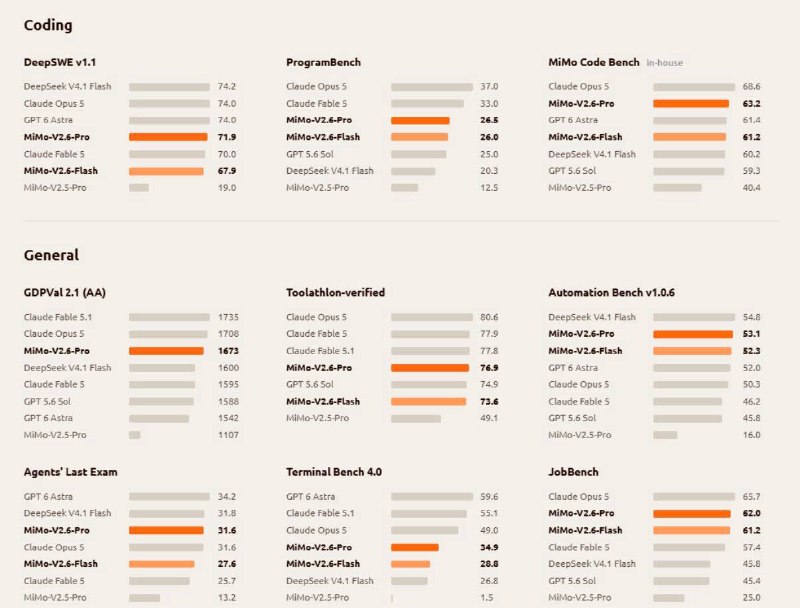
Xiaomi выпустила MiMo-2.6 — открытую мультимодальную модель с контекстом 1 млн токенов, которая по показателям конкурирует с топовыми закрытыми решениями, но стоит значительно дешевле.
Недавно Xiaomi представила модель MiMo-2.6, которая, кажется, стала новой открытой state-of-the-art (SOTA) моделью. По словам разработчиков, версия Pro работает на уровне Claude Opus 5 и GPT-5.6 Sol в большинстве агентных бенчмарков (набрала 46 баллов в Artificial Analysis Intelligence Index).
Архитектурно это MoE, 1.02 млрд параметров и 42 млрд активных, с гибридным вниманием и 5-слойным MTP спекулятивным декодером. Это значит, что модель предполагает сразу несколько токенов вперед, а затем проверяет их валидность параллельно: техника дает хороший прирост к скорости.
Ключевые особенности:
- Контекст: до 1 миллиона токенов.
- Мультимодальность: нативная.
- RL-масштаб: 750 000 RL-траекторий по кодингу, зрению и CFT-задачам.
- Асинхронный GRPO: модель параллельно пробует 16 разных путей решения для каждой задачи.
- Инфраструктура: 7000+ RL-окружений для агентов, которые тоже выложили в опенсорс.
При этом обучение обошлось всего в три миллиона долларов благодаря тому, что гоняли все на верифицируемых задачах без разметки.
Цена тоже не может не радовать:
- Pro: $0.435 / M input, $0.87 / M output
- Flash: $0.14 / M input, $0.28 / M output
Почему это важно
АналитикаВыход MiMo-2.6 подтверждает тренд на доступность топовых AI-моделей через опенсорс, снижая барьер входа для разработчиков агентов благодаря низкой стоимости инференса и обучения.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
LLM (Large Language Model - Большая языковая модель)
Фундаментальный класс нейросетевых архитектур на основе авторегрессионного трансформера, который предполагает вероятностное распределение следующих токенов и демонстрирует эмергентные свойства абстрактного мышления, синтеза кода и логического вывода.
Thinking Machines выпустила новую модель Inkling 2 Small
Thinking Machines представила Inkling 2 Small — MoE-модель на 594B параметров, которая заняла первое место среди открытых моделей в общем лидерборде и умеет самостоятельно дообучать другие модели.
Thinking Machines выпустила Inkling 2 Small: MoE-модель, которая конкурирует с более крупными флагманами
Thinking Machines выпустила Inkling 2 Small — мультимодальную модель на архитектуре Mixture-of-Experts, которая по результатам тестов конкурирует с более крупными флагманами. Полные веса обещают опубликовать на следующей неделе под лицензией Apache 2.0.
Часть I. Архитектура ИИ-агентов: фундаментальные блоки
Одиннадцать фундаментальных строительных блоков современного ИИ-агента: таксономия моделей, агентный рантайм, техники промптинга, дистилляция, архитектура навыков (skills), память, function calling и FinOps.