Реліз дня: MiMo-2.6 від Xiaomi — нова відкрита SOTA-модель
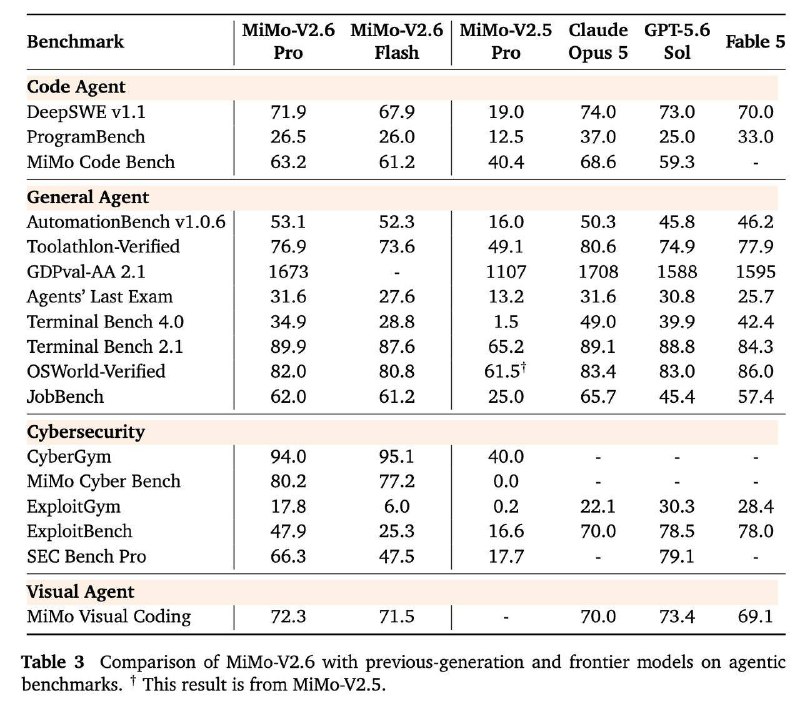
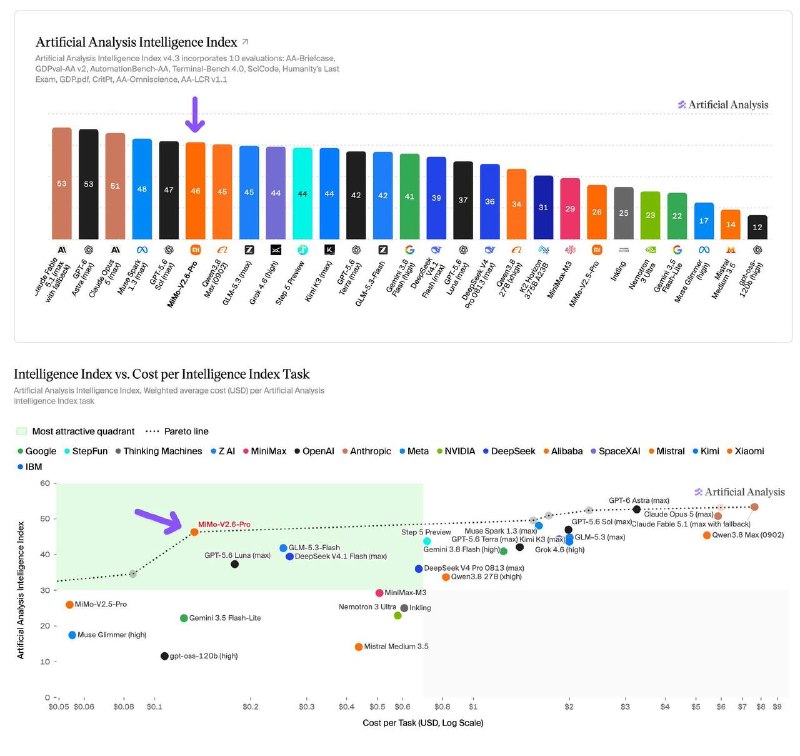
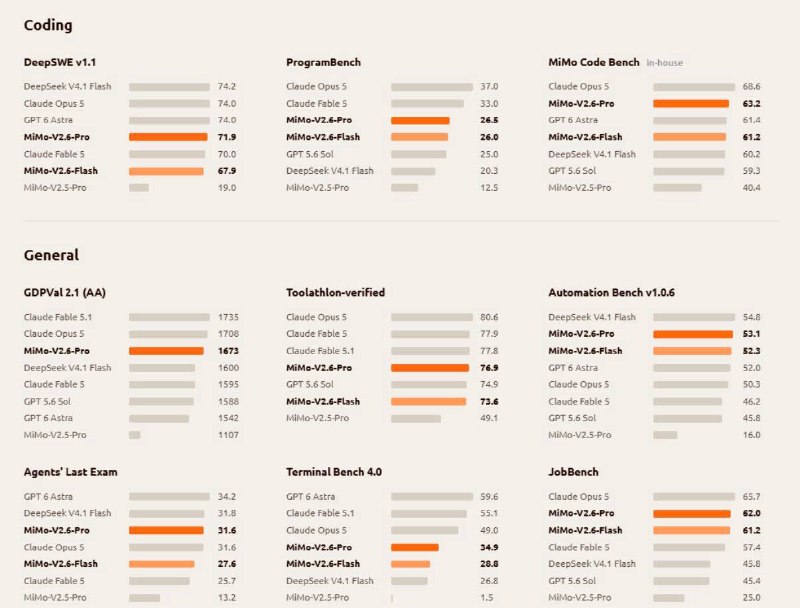
Xiaomi випустила MiMo-2.6 — відкриту мультимодальну модель з контекстом 1 млн токенів, яка за показниками конкурує з топовими закритими рішеннями, але коштує значно дешевше.
Нещодавно Xiaomi представила модель MiMo-2.6, яка, здається, стала новою відкритою state-of-the-art (SOTA) моделлю. За словами розробників, версія Pro демонструє продуктивність на рівні Claude Opus 5 та GPT-5.6 Sol у більшості агентних бенчмарків (набір 46 балів у Artificial Analysis Intelligence Index).
Архітектурно це MoE-модель з 1.02 млрд параметрів (42 млрд активних), яка використовує гібридну увагу та 5-шаровий MTP спекулятивний декодер. Це дозволяє моделі передбачати кілька токенів наперед та паралельно перевіряти їх валідність, що значно прискорює генерацію.
Ключові особливості:
- Контекст: до 1 мільйона токенів.
- Мультимодальність: нативна підтримка різних типів даних.
- RL-навчання: 750 000 траєкторій для кодування, зору та CFT-задач.
- Асинхронний GRPO: модель паралельно пробує 16 різних шляхів рішення для кожної задачі.
- Інфраструктура: 7000+ RL-середовищ для агентів викладені в опенсорс.
Вартість навчання склала лише $3 млн завдяки використанню верифікованих задач без розмітки.
Ціни API:
- Pro: $0.435 / M input, $0.87 / M output
- Flash: $0.14 / M input, $0.28 / M output
Чому це важливо
АналітикаВихід MiMo-2.6 підтверджує тренд на доступність топових AI-моделей через опенсорс, знижуючи бар'єр входу для розробників агентів завдяки низькій вартості інференсу та навчання.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
LLM (Large Language Model - Велика мовна модель)
Фундаментальний клас нейромережевих архітектур на базі авторегресійного трансформера, що передбачає ймовірнісний розподіл наступних токенів і демонструє емерджентні властивості абстрактного мислення, синтезу коду та логічного висновку.
Thinking Machines випустила модель Inkling 2 Small: MoE на 594B параметрів і автономне дообучання інших моделей
Thinking Machines представила Inkling 2 Small — велику MoE-модель, яка вже лідирує серед відкритих моделей у низці задач і вміє самостійно дообучати інші моделі.
Thinking Machines представила Inkling 2 Small: MoE-модель, яка конкурує з більшими флагманами
Thinking Machines представила Inkling 2 Small — мультимодальну модель на архітектурі Mixture-of-Experts, яка за результатами тестів змагається з набагато більшими флагманами. Повні ваги обіцяють опублікувати наступного тижня під ліцензією Apache 2.0.
Частина I. Архітектура ШІ-агентів: фундаментальні блоки
Десять фундаментальних блоків сучасного агента: таксономія моделей, рантайм-петля, техніки промптингу, дистиляція, навички (skills), пам'ять, function calling та юніт-економіка.