Nouveau PDG d'Apple : John Ternus
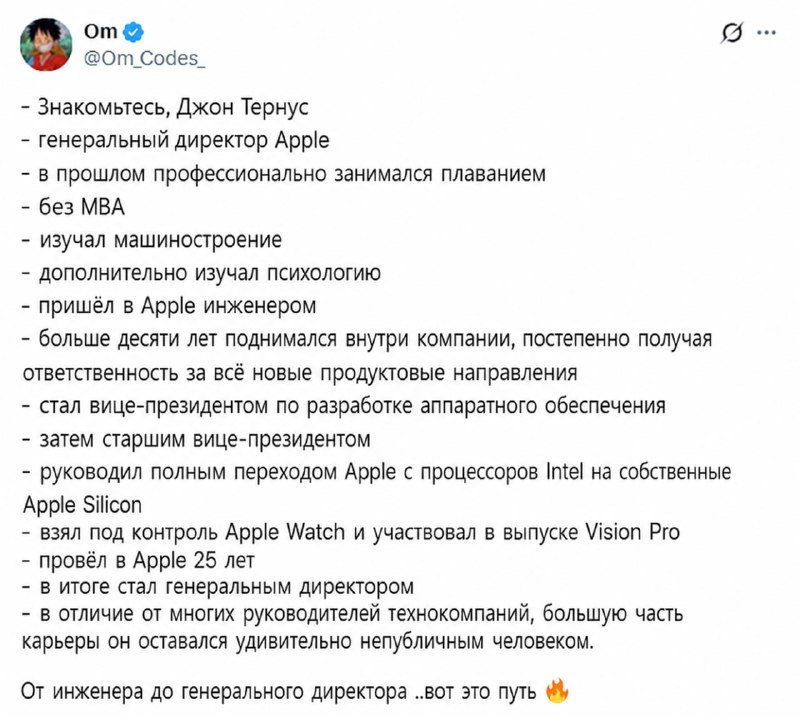
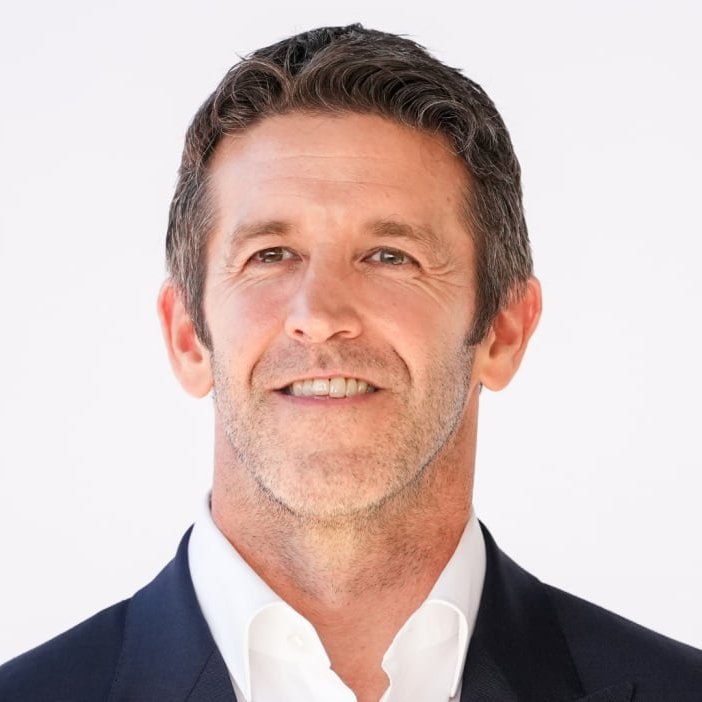
John Ternus, vétéran de vingt-cinq ans chez Apple, prend la tête de l'entreprise en tant que nouveau directeur général.
Nouveau PDG d'Apple : John Ternus
Après vingt-cinq années passées au sein d'Apple, John Ternus accède au poste de directeur général. Cette nomination constitue un tournant majeur pour la firme à la pomme, qui poursuit le développement de ses technologies et innovations.
Fort d'une expérience approfondie acquise tout au long de sa carrière chez Apple, Ternus est idéalement positionné pour guider l'entreprise dans un marché technologique en perpétuelle mutation.
Pourquoi c'est important
AnalyseUn changement de leadership peut redéfinir la stratégie globale et orienter les futures innovations de l'entreprise.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Site d'actualités IA auto-actualisé avec Claude Code
Guide d'ingénierie pas à pas pour créer un site d'actualités sur l'IA, au style journal, auto-actualisé grâce à Claude Code : prompts de conception, limites de confiance, déduplication et exécution planifiée.
Mise à jour d'ElevenLabs : aperçu des nouveaux outils et de la gestion vocale
Guide complet sur la génération de parole dans ElevenLabs : présentation des modèles (v3, Multilingual v2, Flash, Turbo), balises audio d'intonation, phonèmes IPA/Arpabet, lexiques PLS et règles de normalisation du texte.
Apple Silicon pour l'IA (Série M et mémoire unifiée)
L'architecture des processeurs Apple (M1/M2/M3/M4) avec mémoire unifiée (Unified Memory Architecture). Elle permet à l'ensemble de la RAM (jusqu'à 128-192 Go) d'être accessible au GPU comme VRAM, rendant possible l'exécution de très grands modèles de réseaux de neurones sans nécessiter de cartes graphiques serveur.
Framework MLX pour Apple Silicon
Bibliothèque native d'apprentissage automatique conçue par Apple, optimisée pour tirer pleinement parti de la mémoire unifiée et des cœurs graphiques des puces de la série M (M2/M3/M4) lors de l'exécution de grands modèles de langage (LLM).