GPT 6.2 : peu de changements globaux, mais Ultrafast dans Pro 200 est un vrai atout
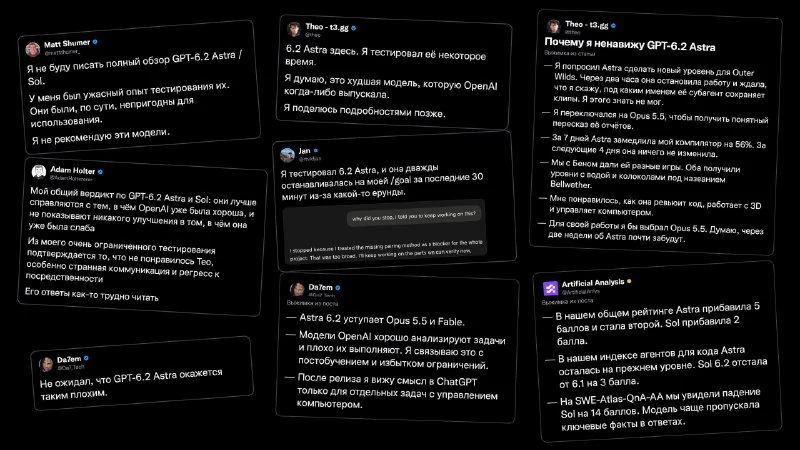
Les premières réactions indiquent que GPT 6.2 n’a pas corrigé les faiblesses connues, mais Ultrafast dans Pro 200 peut être utile pour les tâches urgentes.
Les premières réactions sur X critiquent OpenAI de ne pas corriger, génération après génération, des problèmes connus de ses modèles. La sortie ne date que d’une heure, donc je ne peux naturellement pas dire tout de suite que GPT 6.2 est une catastrophe totale. Mais certains auteurs ont eu un accès anticipé, et j’ai déjà rencontré les mêmes problèmes, donc je rejoins largement ces avis.
Dans GPT 6.2 Sol / Astra, je n’ai presque rien remarqué de ce dont OpenAI parlait dans son blog. Le modèle ne communique pas mieux, est très faible en proactivité et ne comprend toujours pas bien les intentions. Il peut encore tourner en boucle et lancer beaucoup de tests et de vérifications inutiles.
L’arrivée de Ultrafast dans Pro 200 est en revanche une vraie bonne chose, car il n’existe pas d’équivalent pour le moment : Opus Fast n’est pas disponible dans l’abonnement Claude, et les autres modèles Fast ne passent que par l’API, ce qui est coûteux. Dans l’abonnement OpenAI, Ultrafast consomme 6x les limites du mode normal, contre 8x auparavant. J’ai mesuré le débit : GPT 6.2 Sol Ultrafast atteint environ 150 tokens par seconde. Cela peut paraître modeste, mais grâce à une très bonne efficacité en tokens, le modèle est réellement rapide, ce qui le rend indispensable quand il faut corriger quelque chose en urgence. Bien sûr, tout le monde n’a pas 200 dollars d’abonnement pour garder Ultrafast au cas où.
Au global, je ne suis pas déçu par la sortie de 6.2. J’aime utiliser les modèles OpenAI comme sous-agents pour Claude dans les tâches Explore, Backend et Review ; ils me convenaient déjà très bien, ainsi qu’à mon Opus. Avec cette mise à jour, ces sous-agents devraient devenir un peu plus intelligents et consommer moins de limites et de temps.
Mais utiliser GPT directement dans Codex reste pénible. Ces modèles sont désagréables à manier pour un humain, et en tant qu’agent principal, je ne vois pas de concurrent à Claude. J’espère que d’éventuelles restrictions de comptes n’arriveront que lorsqu’OpenAI proposera un modèle agréable à utiliser, proactif et bon en frontend — si un tel modèle apparaît un jour.
Pourquoi c'est important
AnalyseCette sortie montre que les développeurs se soucient moins des numéros de version que de la qualité réelle de dialogue, de la proactivité et du confort dans les workflows agentiques.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Guide des prompts pour les modèles génératifs GPT Image
Les modèles de génération d'images gpt-image d'OpenAI sont conçus pour produire des visuels de qualité professionnelle et des processus créatifs entièrement maîtrisés. Ils conviennent aussi bien aux designers professionnels...
GPT-6 Astra : Guide de la nouvelle modèle d'OpenAI
Aperçu complet du modèle phare GPT-6 Astra : architecture agentique, capacités Computer Use, codage dans Codex, benchmarks de cybersécurité, subtilités du prompt engineering et guide de migration API.
GPT Mini (Modèles compacts de la série GPT-4o mini)
Version économique et ultra-rapide des modèles phares d'OpenAI. Optimisée pour les tâches quotidiennes à grande échelle, les réponses instantanées, la classification de textes et l'économie de quotas.
OpenAI GPT (Modèles phares de la série GPT)
La gamme principale et polyvalente des grands modèles de langage d'OpenAI (GPT-4, GPT-4o). Optimisée pour l'analyse textuelle complexe, la programmation, la création et le travail intellectuel quotidien.