Google restreint l'accès gratuit à Gemini au modèle Flash-Lite
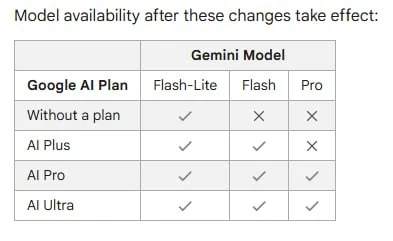
À partir du 9 octobre, les comptes gratuits de Gemini perdront l'accès aux modèles Flash et Pro, ne conservant que Flash-Lite.
Google restreint l'accès gratuit à Gemini au modèle Flash-Lite
À compter du 9 octobre, l'application Gemini commencera à retirer les modèles Flash et Pro des comptes gratuits. Les utilisateurs sans abonnement ne disposeront plus que du modèle Flash-Lite.
Les offres payantes conserveront un accès plus étendu :
- L'offre AI Plus maintiendra l'accès à Flash-Lite et Flash.
- Les offres AI Pro et Ultra garderont l'accès aux trois modèles : Flash-Lite, Flash et Pro.
Plus de détails sont disponibles sur la page d'assistance de Google.
Pourquoi c'est important
AnalyseCette évolution illustre la stratégie croissante des grands fournisseurs d'IA qui segmentent l'accès aux modèles, réservant les capacités avancées aux abonnements payants tout en limitant les utilisateurs gratuits à des versions allégées.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Google présente Gemini 4 Neon : le modèle dépasse Claude Opus 5.5 et GPT-6.2 Sol en code et en scénarios agentiques
Google a présenté Gemini 4 Neon, une nouvelle IA qui, selon les résultats annoncés, surpasse Claude Opus 5.5 et GPT-6.2 Sol dans la plupart des tests.
Google AI Studio : clés API Gemini gratuites
Le bac à sable officiel de Google : comment obtenir une clé API Gemini gratuite sans carte bancaire, configurer les prompts système et les limites de contexte de 2 millions de tokens.
Gemini Notebook transforme les sources en sites interactifs
Gemini Notebook (anciennement NotebookLM) peut désormais créer des sites interactifs, tableaux de bord et fiches de révision visuelles à partir de PDF, notes et liens.
Gemini Flash & Pro (Google Gemini)
La famille de modèles multimodaux de Google DeepMind, qui combine une fenêtre contextuelle record (jusqu'à 2 millions de tokens), une vitesse de génération extrême (plus de 150 tokens/s) et une perception native de la vidéo et de l'audio.