Le Registre fédéral américain utilise le modèle chinois Qwen pour la recherche de documents
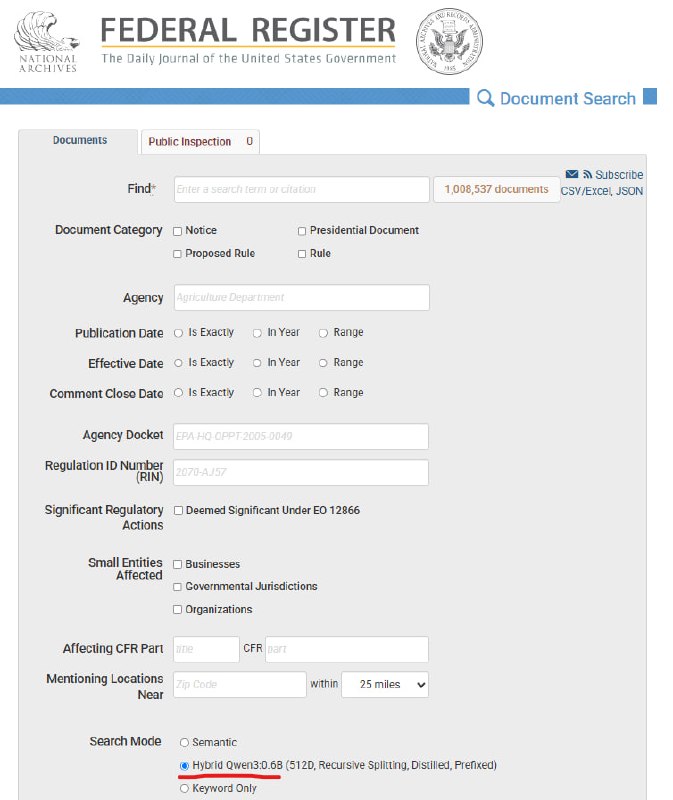
Le Registre fédéral des États-Unis s'appuie sur une version distillée du modèle chinois Qwen pour indexer les documents gouvernementaux, créant un paradoxe frappant face aux accusations portées contre Pékin.
Le Registre fédéral des États-Unis utilise actuellement une version distillée du modèle d'intelligence artificielle chinois Qwen pour effectuer des recherches à travers les documents gouvernementaux.
Les paramètres techniques indiquent explicitement l'utilisation de Hybrid Qwen3:0.6B Distilled.
Cette situation apparaît particulièrement ironique dans le contexte actuel, marqué par les accusations répétées contre la Chine concernant la « distillation de modèles à l'échelle industrielle » et les préoccupations liées à la sécurité nationale.
Pourquoi c'est important
AnalyseCet épisode met en lumière la dépendance mondiale croissante aux modèles d'IA open source chinois, tout en soulignant l'ironie profonde des tensions géopolitiques actuelles autour du vol présumé de technologies d'intelligence artificielle.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
JSON — données structurées pour les applications, les API et les agents IA
Guide pratique complet du format JSON : règles de syntaxe, sérialisation via parse/stringify, intégration avec les API REST, schémas JSON et sortie structurée pour l'intelligence artificielle.
Format CSV : guide complet pour l'automatisation et le travail avec l'IA
Guide pratique sur l'utilisation du format CSV dans les pipelines d'IA : spécification RFC 4180, comparaison avec XLSX et JSON, nettoyage et enrichissement massif des données, codage en Python et prompts prêts à l'emploi.
Distillation de modèles et transfert du raisonnement
Méthodologie de transfert des connaissances et des chaînes de raisonnement d'un modèle enseignant géant (Teacher Model) vers un modèle étudiant compact (Student Model), permettant une inférence rapide et économique.
Un utilisateur Reddit explique pourquoi les limites hebdomadaires de Claude Code se consomment presque 4 fois plus vite
Un utilisateur Reddit a comparé l’utilisation des tokens sur deux semaines et constaté que chaque 1 % de la limite hebdomadaire de Claude Code génère désormais beaucoup moins de tokens de sortie ; des sous-agents, la durée du raisonnement et les rafraîchissements de l’interface sont pointés comme causes possibles.